
大手AI企業のOpenAIが、EUのAI法を順守するためにChatGPTやCodexによって生成されたテキストに、目に見えない透かしを追加すると発表しました。
Our approach to EU text provenance rules | OpenAI
https://openai.com/index/eu-text-provenance/
OpenAI will start watermarking ChatGPT’s text in the EU | TechCrunch
https://techcrunch.com/2026/10/05/openai-will-start-watermarking-chatgpts-text-in-the-eu/
EUのAI法により、AI生成コンテンツに対して「人工的に生成したものであることを識別できるような表示」が義務化されました。
EUの「AI法」によりAI生成コンテンツにラベル表示が義務付け – GIGAZINE
OpenAIはこのAI法を順守するために、AI生成テキストに透かしを追加すると発表しました。この透かし機能は今後数週間以内に、対象となるChatGPTおよびCodexの全プランユーザーに展開される予定。なお、対象となるのはEU圏内のユーザーです。
世界中のOpenAI APIを利用する開発者は、一部のAIモデルでこの機能を有効にすることが可能。ただし、デフォルトでは無効化されています。OpenAIは記事作成時点ではテキスト透かし機能を全世界でデフォルトで有効にする予定はないと説明しました。
OpenAIのテキスト透かしは、AIモデルの単語選択を微妙に変化させることで機能します。人間の読者には見えないパターンを残し、検出器を用いることでこれを検出することが可能。単語自体に組み込まれているため、テキストをコピー&ペーストしてもそのまま機能することができます。
OpenAIは、テキスト透かしがユーザーに特定されることはなく、透かしを有効にしてもAIモデルのパフォーマンスに大きな変化は見られないと説明しました。
さらに、OpenAIはテキスト透かしの発表と同時に、テキスト透かしが含まれるかどうかを判定する「textGrain」という技術に関するレポートを公開しています。
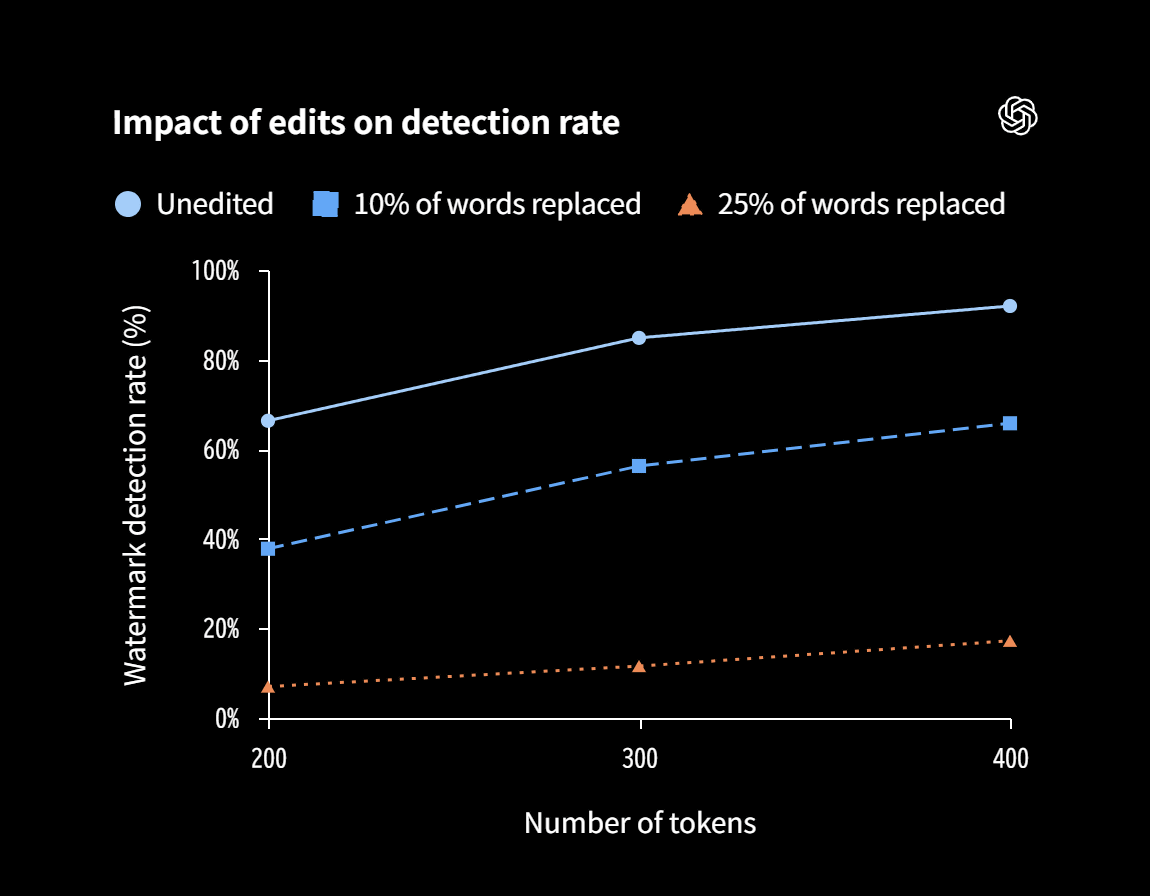
テキスト透かしは万能というわけではなく、単語を同義語に置き換えることで検出率を著しく低下させることが可能。未編集の場合はAI出力であることを検出する割合が92%であるのに対して、文中の単語の10%を同義語に置き換えると検出率は66%まで低下。さらに、単語の25%を置き換えると、検出率は17%にまで低下します。また、OpenAIによると「短い文章」「数学の回答」「翻訳されたテキスト」では検出が難しくなるという欠点もあるそうです。
上記の通り一部制約があるため、初期段階ではテキスト透かし検出器へのアクセスは、承認済み研究者や専門機関のみに制限されます。
OpenAIは「透かしがないからといって人間が書いたものだと証明されるわけではない」と警告しました。また、透かしの存在は文章の生成にAIが関係したことを示すものですが、「そこにどれだけ人間の判断・編集・創造性が投入されたかを判断することはできません」とも記しています。
ソース元はコチラ

この記事は役に立ちましたか?
もし参考になりましたら、下記のボタンで教えてください。