
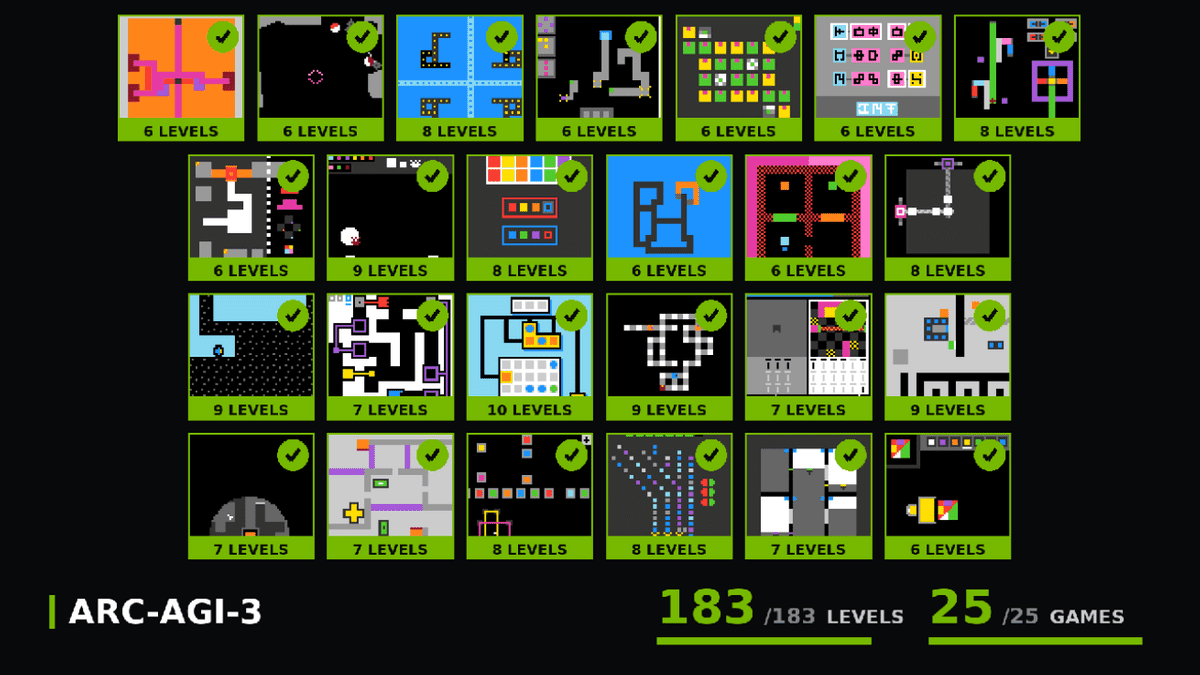
NVIDIAが開発するAIエージェントシステム「Agentic Variation Operators(AVO)」が、AIが未知の環境とやり取りしながら推論する能力を測るベンチマーク「ARC-AGI-3」の公開セットで100%のスコアを達成しました。ベースに使われたClaude Opus 5について、ARC-AGI-3を開発したARC Prizeが別条件のモデル評価でのスコアを約30%と報告しており、長時間のタスクではAIモデル単体だけでなく記憶やツール利用などを担う周辺システムの重要性が示されています。
NVIDIA AVO Reaches 100% on ARC-AGI-3, Demonstrating a Frontier-Level General-Purpose Architecture for Long-Horizon Autonomous Agents | NVIDIA Technical Blog
https://developer.nvidia.com/blog/nvidia-avo-reaches-100-on-arc-agi-3-demonstrating-a-frontier-level-general-purpose-architecture-for-long-horizon-autonomous-agents/
ARC-AGI-3は問題文を読んで答える一般的なベンチマークとは異なり、ルールも目的も分からないゲームのような環境をAI自身に操作させます。AIは実際に行動して結果を観察しながら、何をすればゴールに近づくのかを推測しなければなりません。公開セットには25種類の環境と合計183レベルが用意されています。
AIの知能をルール不明のゲームで測定する「ARC-AGI-3」が登場、AIはまだクリアできないが人間には100%クリアできるゲームを実際にプレイ可能 – GIGAZINE
ARC-AGI-3の評価には「Relative Human Action Efficiency(RHAE)」と呼ばれる指標が使われます。単にゲームをクリアできるかだけでなく、初めてゲームを遊ぶ人間から算出した基準と比べて何回の操作でクリアできたかも評価対象になるため、RHAEで100%を得るには全ゲーム・全レベルをクリアしながら、人間と同等以上の操作効率を維持する必要があります。
長時間にわたって試行錯誤する課題では、高性能なAIモデルを呼び出すだけでは過去の失敗や発見を十分に生かせない場合があります。そこで重要になるのがAIモデルの周囲で記憶、ツール利用、状態管理、失敗からの復帰などを担当する「実行基盤(ハーネス)」です。
AVOは長時間の自律作業を続けるために、過去の試行や評価結果を残す永続的なメモリと、作業が行き詰まった際に別の方針へ誘導する監督機能を備えています。メインのエージェントは状況確認、計画、実行、評価を繰り返しながら作業を進めます。
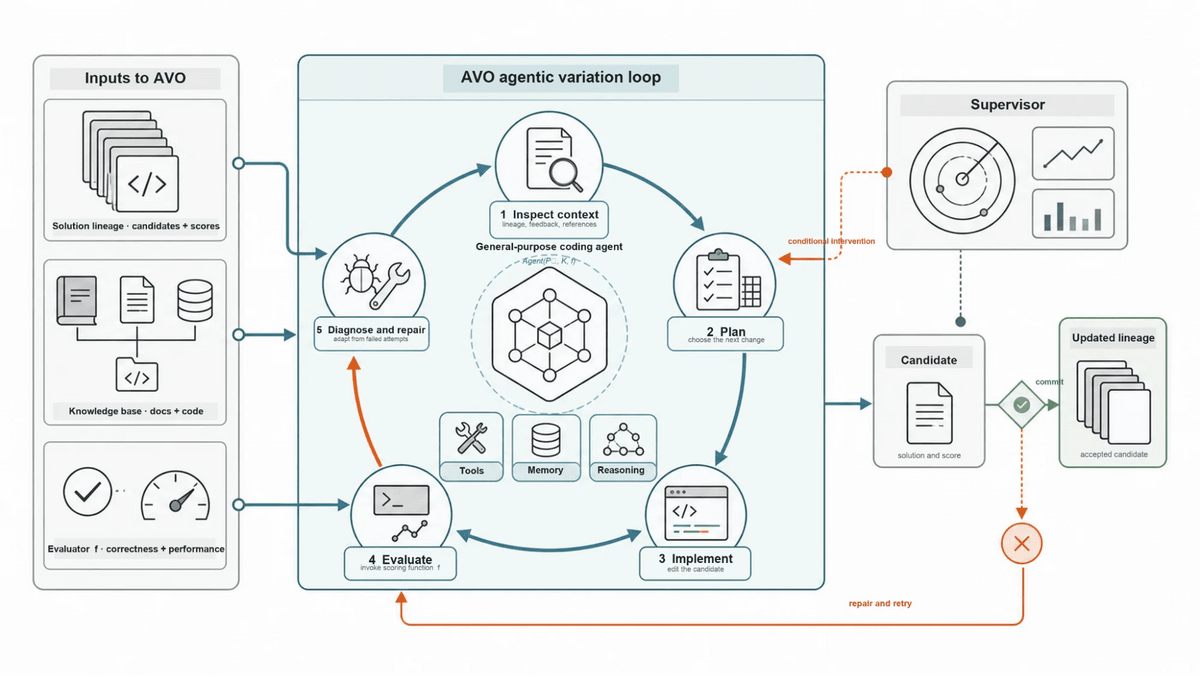
NVIDIAはGPUカーネル最適化向けに開発していたAVOの基本構造を維持したまま、ARC-AGI-3を操作するためのインターフェースを追加しました。AVOのベースAIモデルとしてClaude Opus 5を使用した場合、公開セットの合計183レベルをすべてクリアしRHAEで100%を記録したとのこと。
ARC-AGI-3の開発元であるARC Prizeが行った別条件でのClaude Opus 5のARC-AGI-3の評価ではRHAEが約30%でした。AVOが同じモデルをベースに使用しながらRHAE100%を記録したという結果は、AIモデルの評価だけではエージェントシステム全体の性能を表せないことを示す例となっています。
NVIDIAはARC-AGI-3で重要なのは100%という数字だけではなく、GPUコード最適化向けに作られた同じエージェント構造が未知のゲーム攻略にも応用できた点だと説明しています。さらに「AIモデル自体の性能だけでなく、記憶やツール、フィードバック、失敗からの復帰を含めたシステム全体が長時間の自律作業を左右する」と述べており、こうした傾向が他のモデルでも見られるかについてはより幅広いモデルを使った検証が必要だとしています。
ソース元はコチラ

この記事は役に立ちましたか?
もし参考になりましたら、下記のボタンで教えてください。