
AI企業のLiquid AIはノートPCやスマートフォンといった低スペックなデバイスでも実行できる小型AIモデルとしてLFM2.5シリーズを展開しています。新たにLFM2.5シリーズに量子化認識蒸留(QAD)という省メモリ化しつつ性能低下を抑える技術を適用したバージョンがオープンモデルとして公開されました。
LFM2.5 Q4_0: Quantization-Aware Distillation for Edge Deployment — Blog — Liquid AI
https://www.liquid.ai/blog/qad
AIモデルを省メモリ化には「量子化」という手法が広く用いられています。しかし、量子化は「モデルの計算精度を下げる」という仕組みでサイズを縮小しているため、量子化版モデルはベースモデルと比べて性能が低下してしまいます。QADは高精度モデルを教師モデルとして量子化版モデルを蒸留することで量子化によって失った性能を回復させる技術で、省メモリ化しつつ性能は維持できる手法として注目されています。
LFM2.5シリーズはパラメーター数や用途の異なる複数のモデルが公開されています。今回QAD版が公開されたのは「LFM2.5-230M」「LFM2.5-350M」「LFM2.5-1.2B-Instruct」「LFM2.5-2.6B」の4種類で、Q4_0で量子化したモデルに蒸留を施して性能を向上させています。
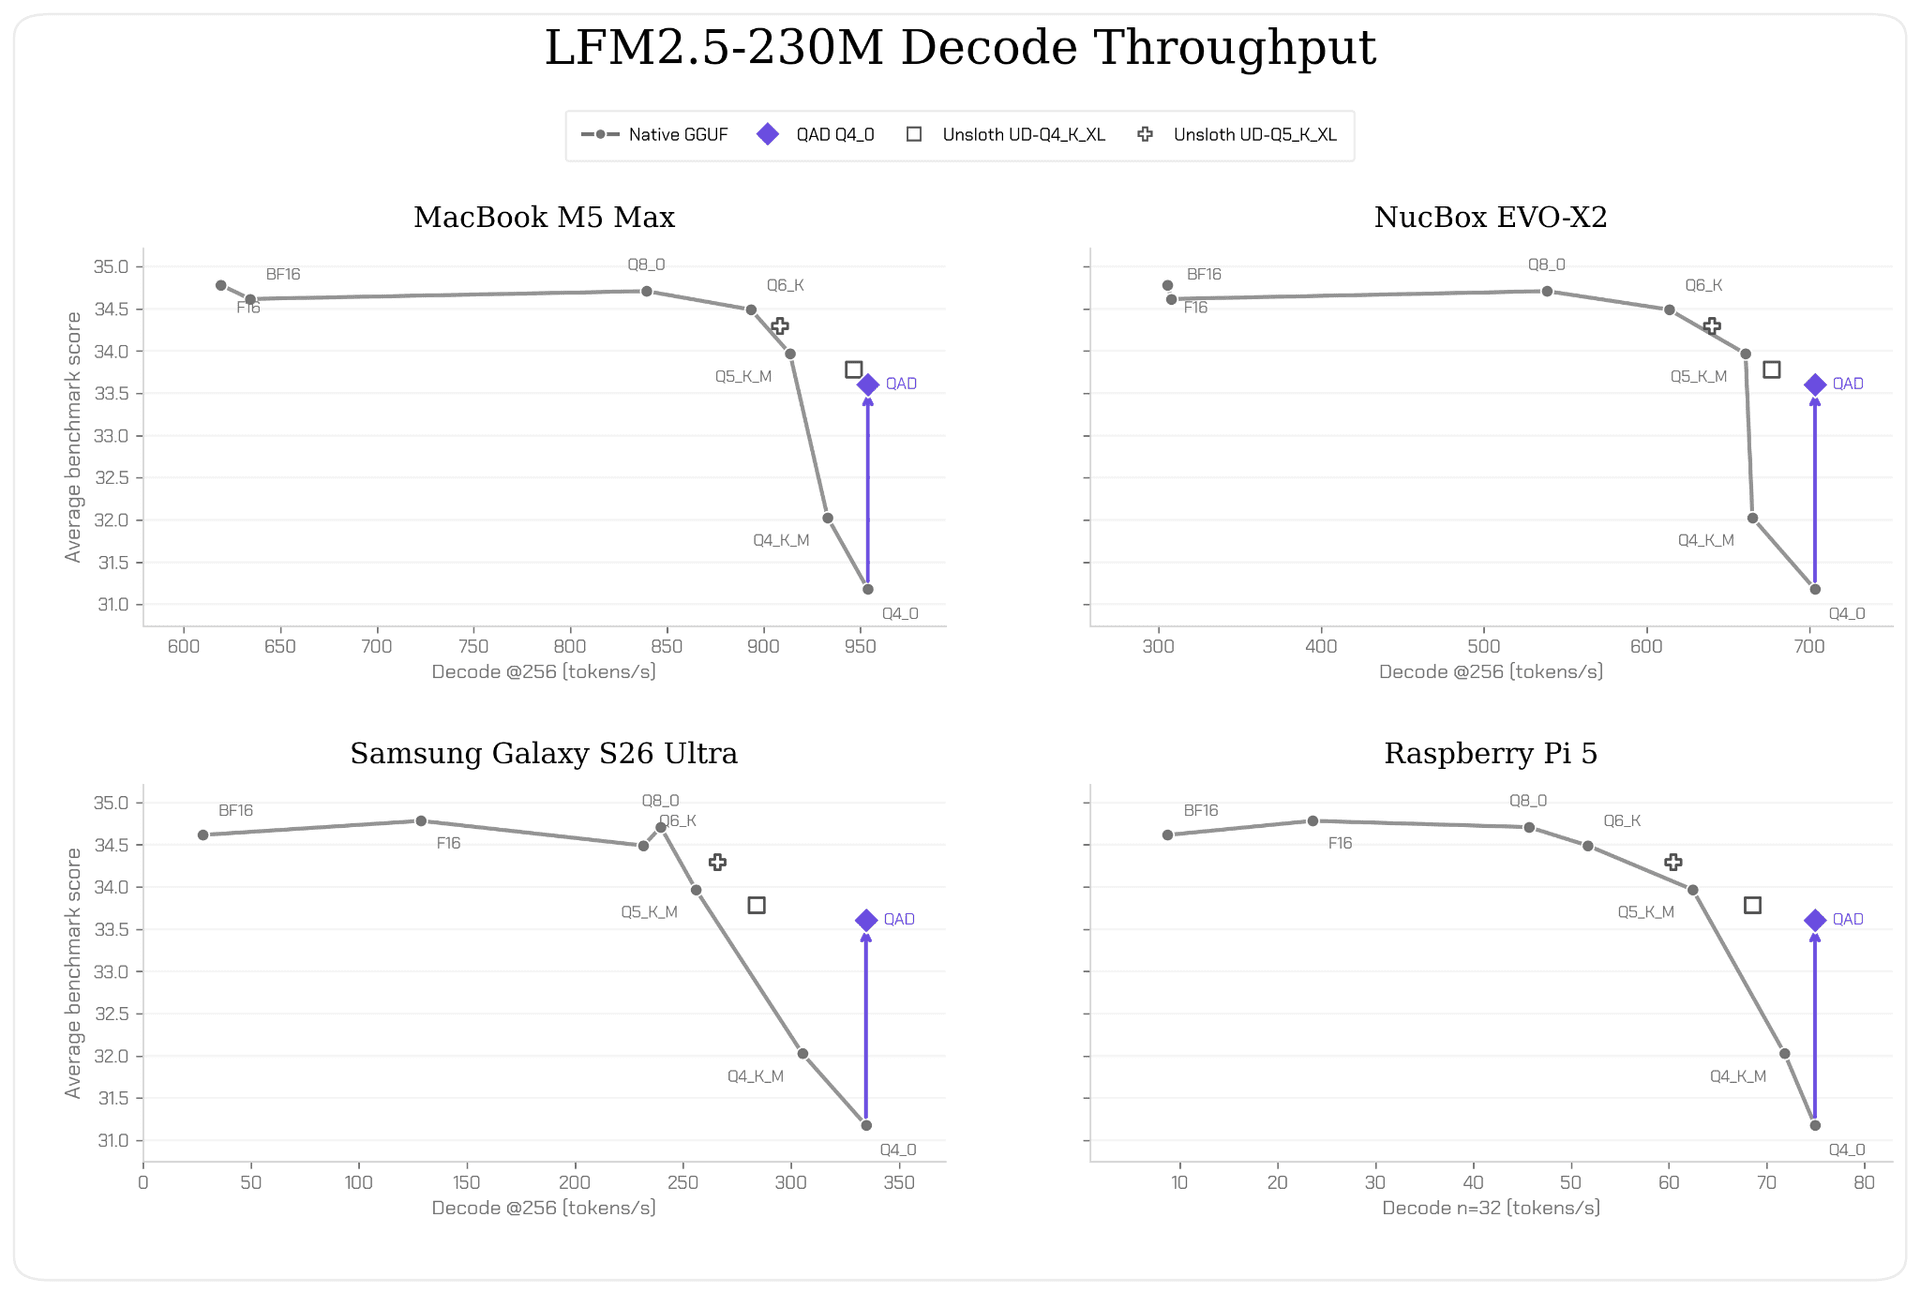
LFM2.5-230Mを「M5 Max搭載MacBook Pro」「AMD Ryzen AI Max+ 395を搭載したミニPC(NucBox EVO-X2)」「Samsung Galaxy S26 Ultra」「Raspberry Pi 5」で実行した際の量子化精度ごとのベンチマークスコアを並べた図が以下。QAD版はQ4_0版から性能が大幅に向上し、Q5_K_M版に近い性能を示しています。ファイルサイズはQ5_K_M版が172MB、QAD版が149MBなので、QAD版が省メモリ化しつつ性能低下を抑えられたことが分かります。
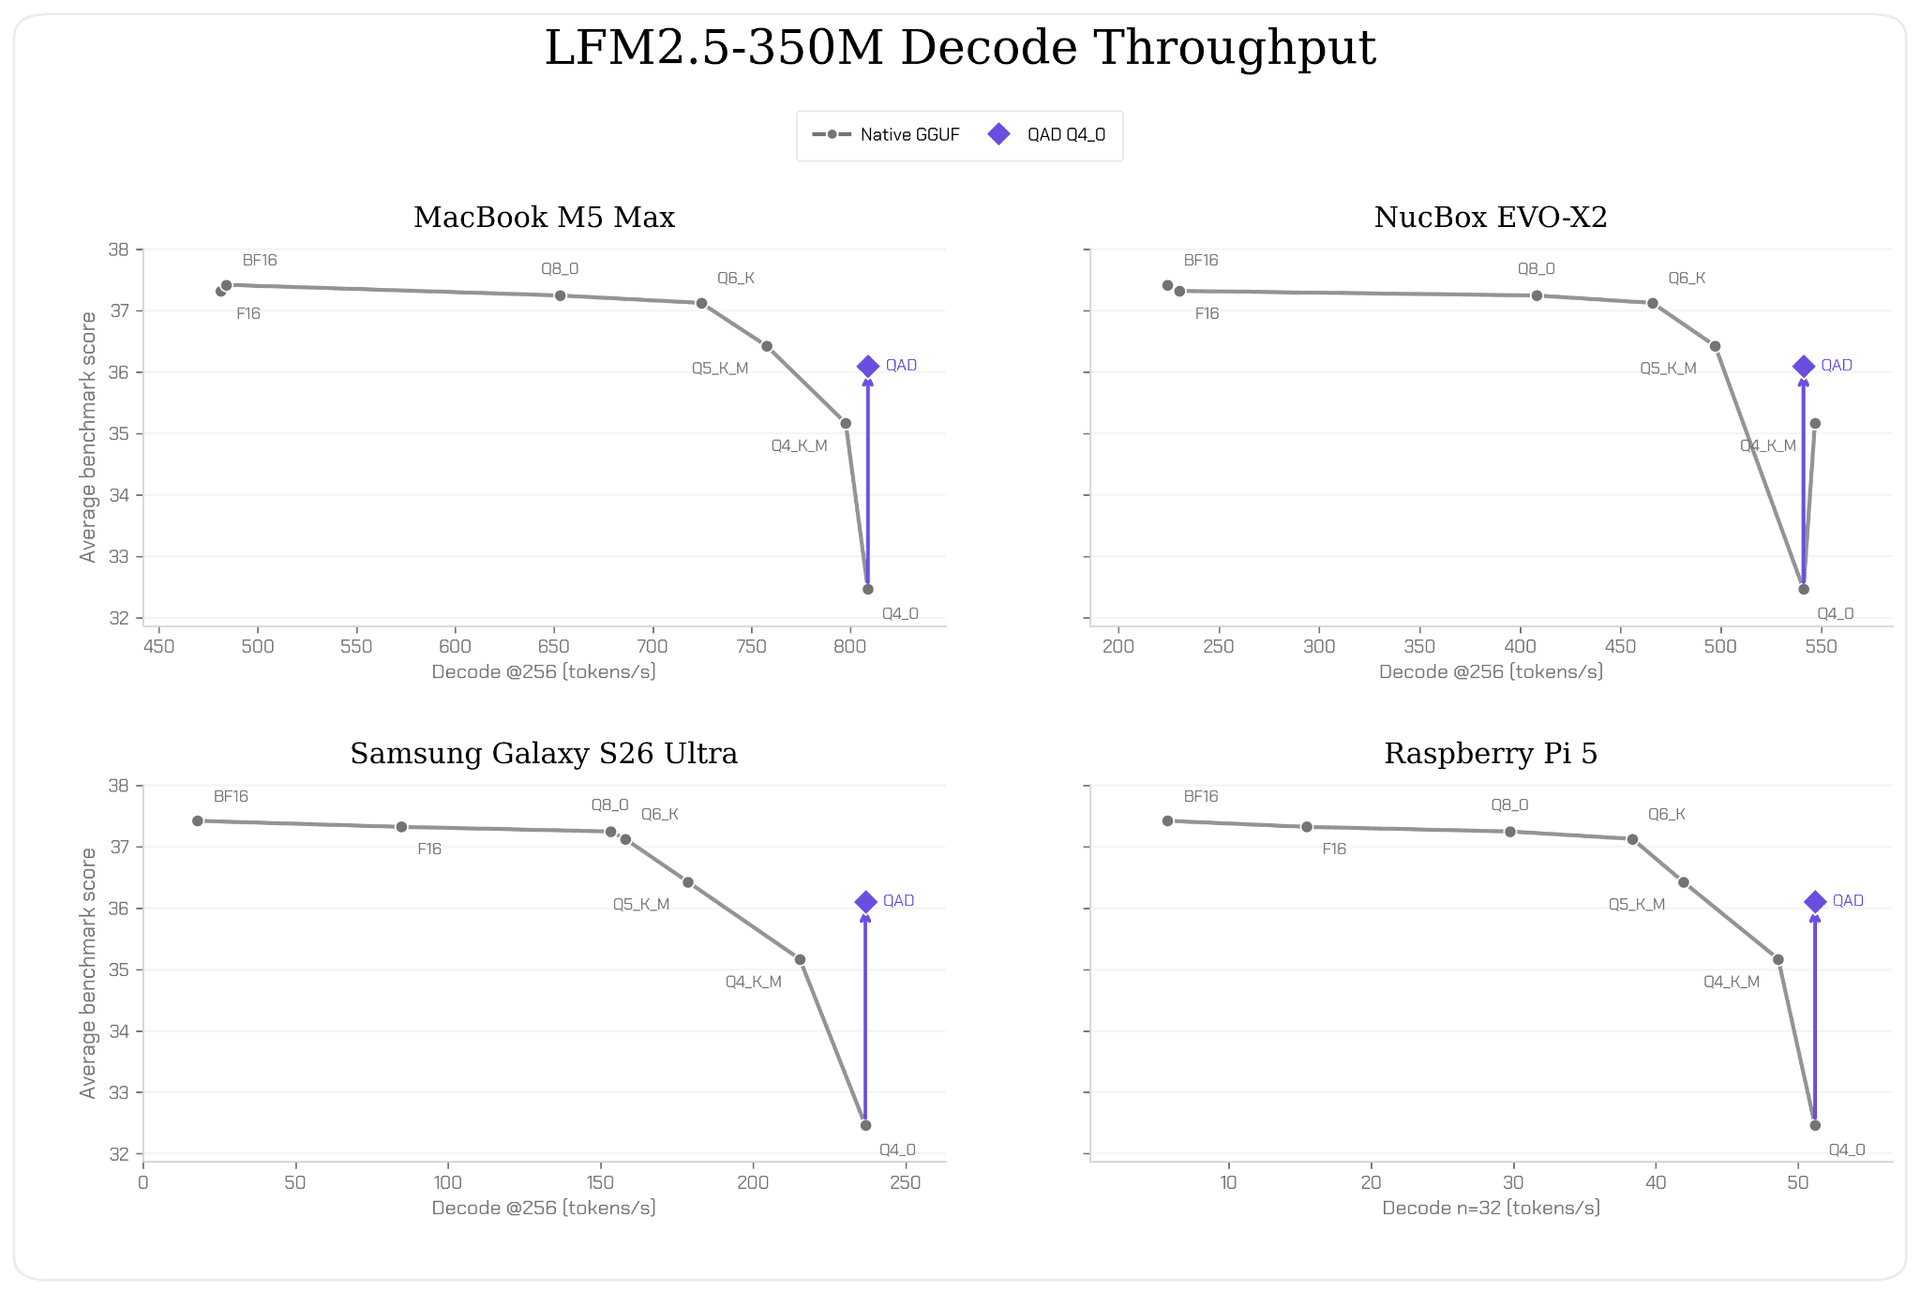
LFM2.5-350Mでも同様に性能低下を抑えつつ省メモリ化に成功。
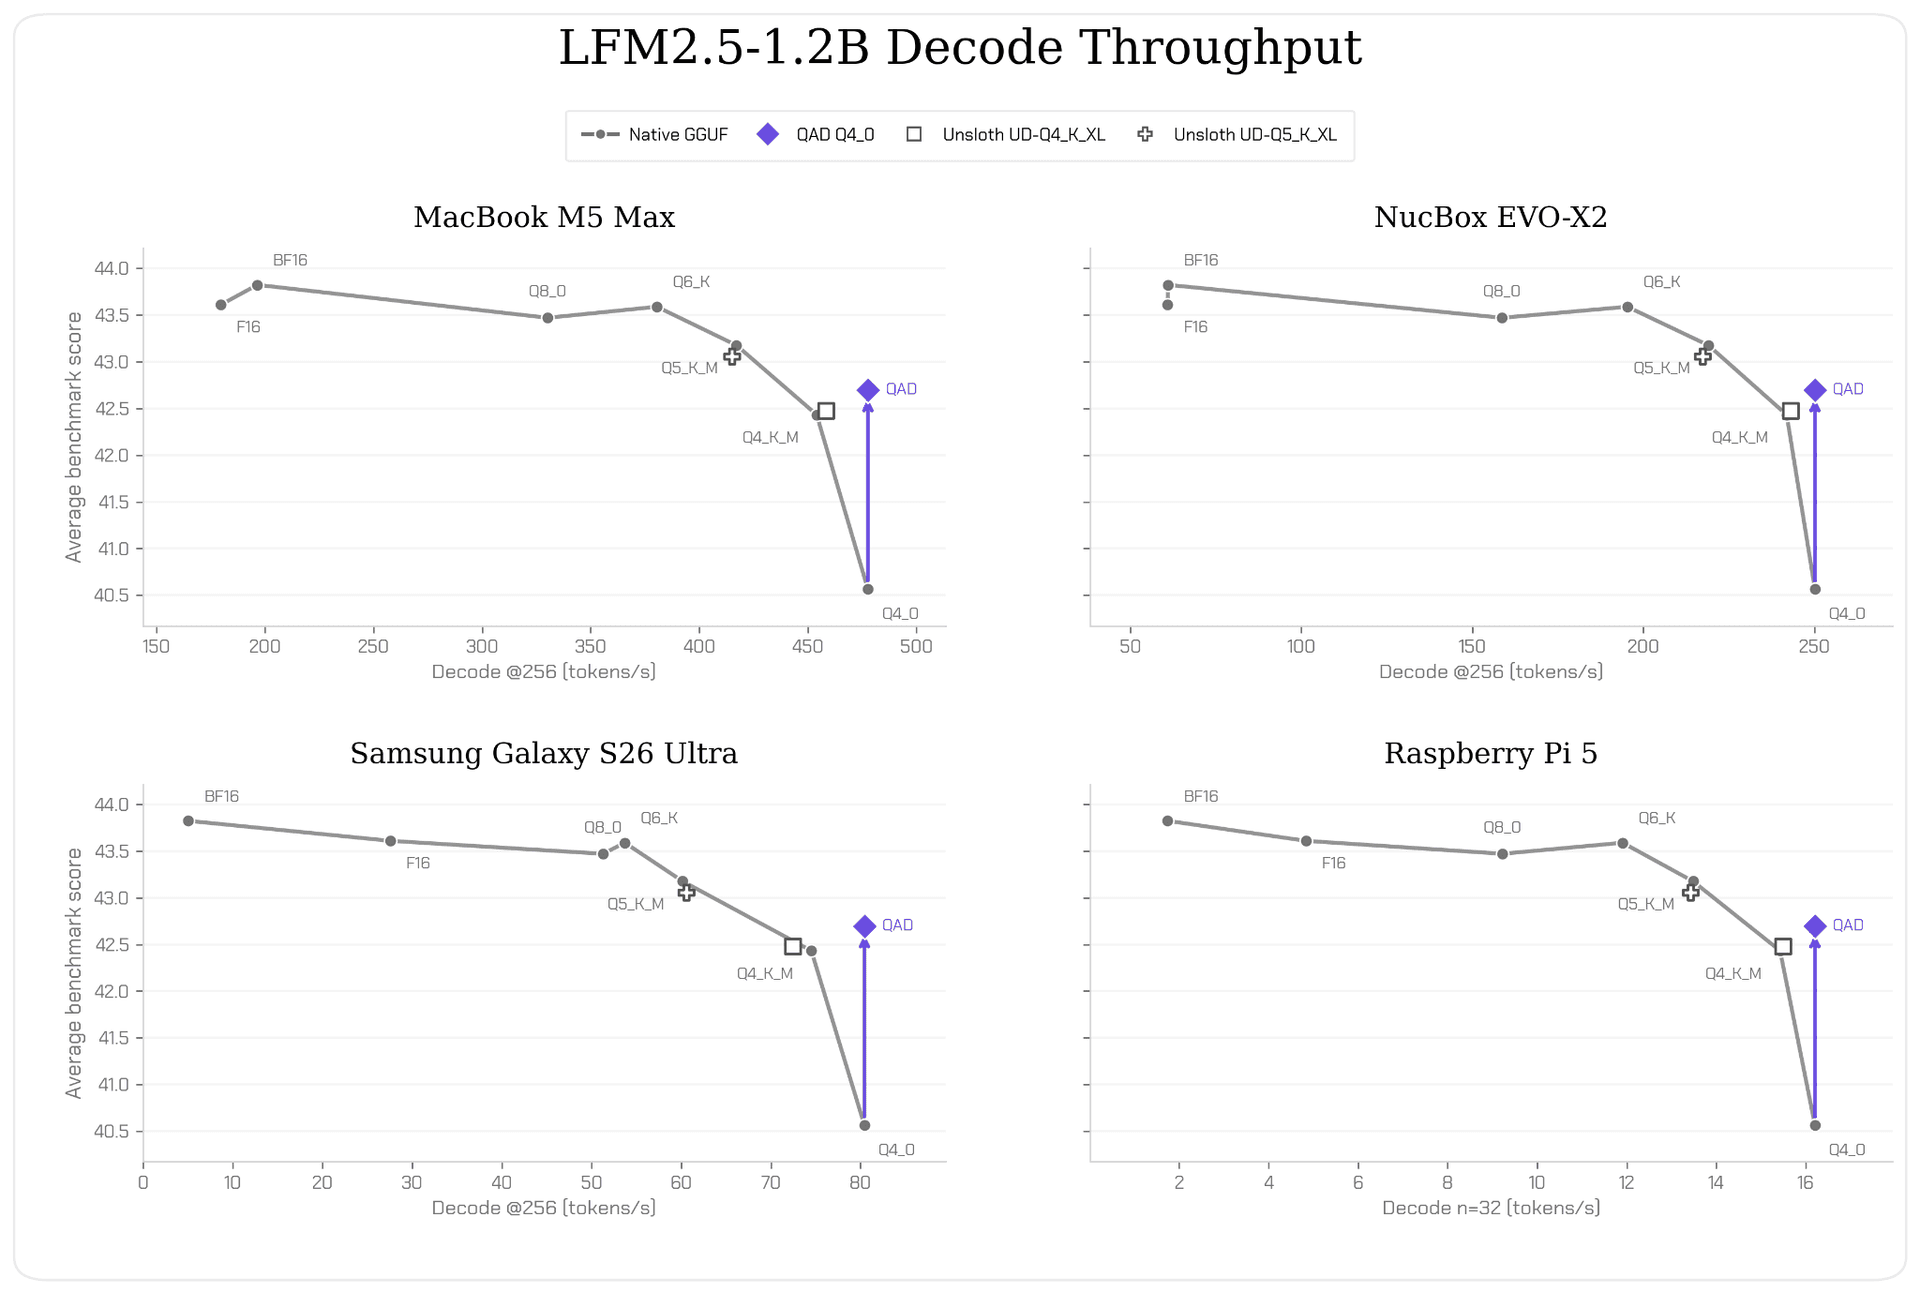
LFM2.5-1.2B-Instructでも同様の効果を発揮しています。
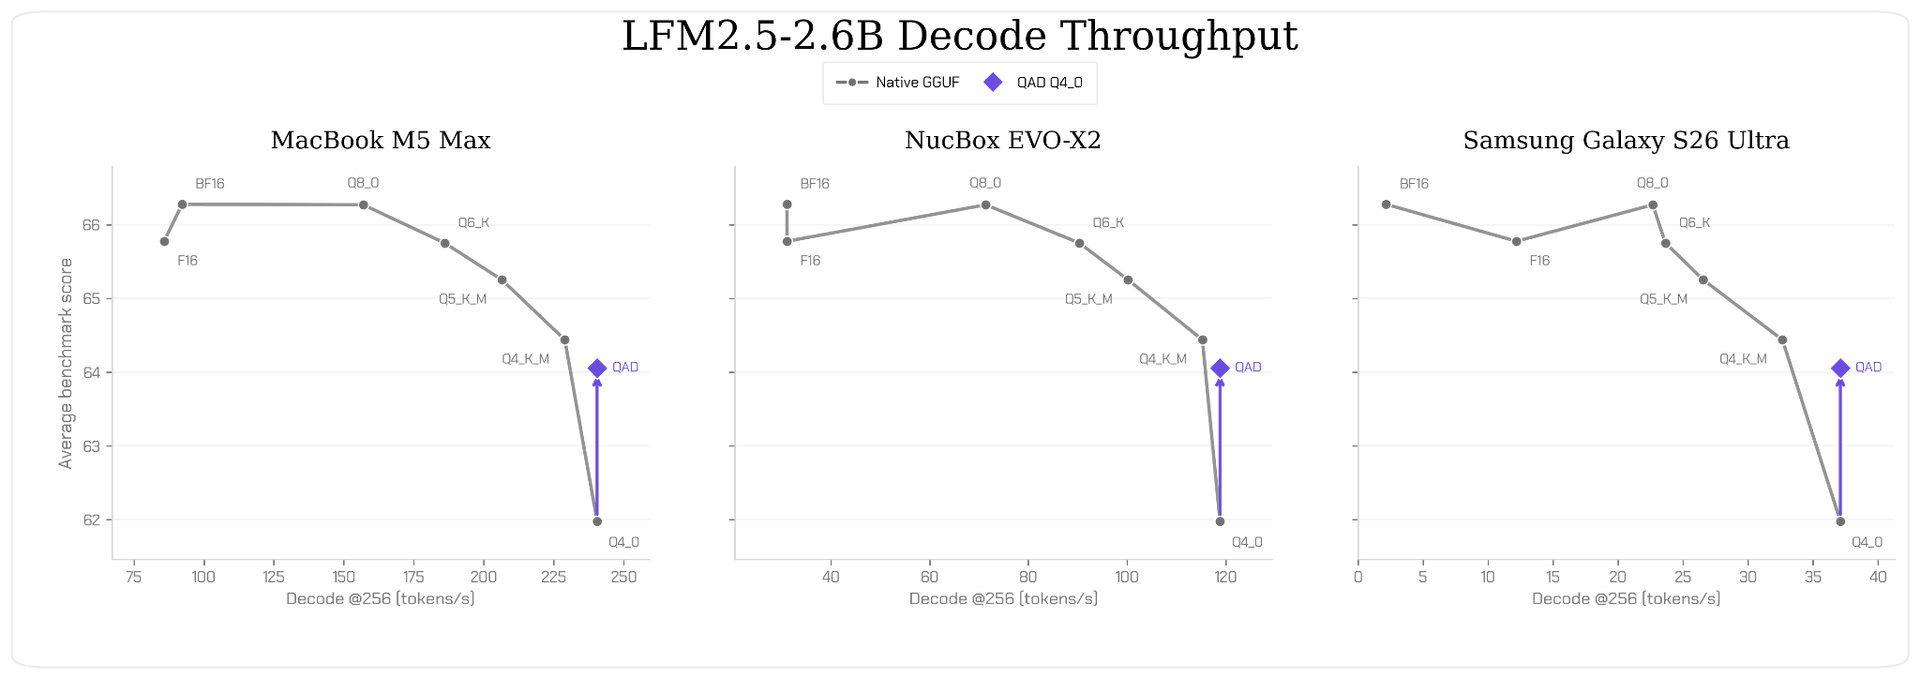
LFM2.5-2.6Bの場合はQ4_0版よりは性能が向上したももの、Q4_K_M版に及ばない結果となりました。
LFM2.5シリーズはオープンモデルとして無償公開されており、各モデルのQAD版も以下のリンク先で配布されています。
LiquidAI/LFM2.5-230M-GGUF · Hugging Face
https://huggingface.co/LiquidAI/LFM2.5-230M-GGUF
LiquidAI/LFM2.5-350M-GGUF · Hugging Face
https://huggingface.co/LiquidAI/LFM2.5-350M-GGUF
LiquidAI/LFM2.5-1.2B-Instruct-GGUF · Hugging Face
https://huggingface.co/LiquidAI/LFM2.5-1.2B-Instruct-GGUF
LiquidAI/LFM2.5-2.6B-GGUF · Hugging Face
https://huggingface.co/LiquidAI/LFM2.5-2.6B-GGUF
ソース元はコチラ

この記事は役に立ちましたか?
もし参考になりましたら、下記のボタンで教えてください。