
アメリカに拠点を置くAIスタートアップのReflectionが、パラメーター数5010億・アクティブパラメーター数230億のオープンモデル「Beam」を発表しました。
Introducing Beam: Reflection’s 501B open-weight model — Reflection
https://reflection.ai/blog/introducing-beam
Reflection AI unveils its first model, Beam, an open-source answer to Chinese labs | Semafor
https://www.semafor.com/article/10/05/2026/reflection-ai-unveils-an-open-source-answer-to-chinese-labs
Beamは事前学習と強化学習への大規模な投資によって生まれたオープンモデルです。事前学習にはウェブと独自にライセンスを取得したデータセットから集めた、多様で厳選された高品質な23兆8000億トークンを使用。その結果、公開されている同規模のオープンモデルと同等以上の性能を実現することに成功したと、Reflectionは説明しています。
これと同時に、大量の計算資源を必要とする強化学習を極めて大規模に継続するために必要なアルゴリズム・学習環境・インフラを開発。強化学習では、NVIDIA GB 300を1万500基使用して、4週間の学習で1億回を超えるロールアウト(AIモデルが回答や一連の行動を生成する試行)を生成しています。
事前学習と強化学習を組み合わせることで、オープンウェイトモデルとして競争力のある性能と、最先端水準の推論計算効率を実現したとReflectionは主張しています。記事作成時点では、Beamは最終段階のレッドチーミング(攻撃的なテストによる安全性の検証)と評価を受けている最中であるため、モデルは公開されていません。ただし、Reflectionは2026年10月中にBeamのフルウェイトを公開予定と説明しており、以下からウェイティングリストに登録することもできます。
Reflection Playground
https://platform.reflection.ai/login
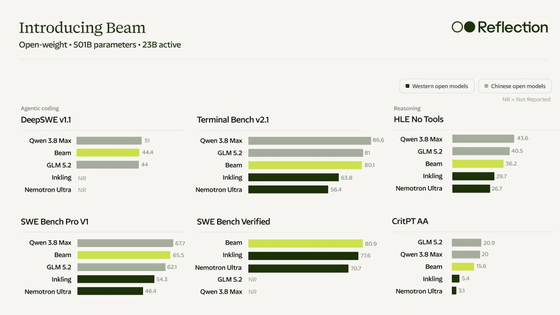
Beamはコーディングおよびエージェントとしての性能に特に重点を置いてトレーニングされています。Beamは欧米のオープンウェイトモデルの到達水準を押し上げ、コーディングやエージェント型タスクで、GLM 5.2のようなより大規模なオープンモデルに匹敵し、Qwen 3.8-Maxに迫る性能を発揮することが可能。Kimi K3のような最先端のオープンモデルには純粋な能力でまだ及ばないものの、Beamには推論時の効率という強みがあると説明しています。
以下の画像は、BeamとGLM 5.2・Qwen 3.8-Max・Inkling・Nemotron Ultraという各種オープンモデルを、複数のベンチマークで比較した結果をまとめたもの。実施したベンチマークはAIコーディングエージェント向けのベンチマークであるDeepSWE、AIエージェントのターミナル環境での総合的な実務遂行能力を測定するTerminal Bench、検索やコード実行などの外部ツールを一切使わずにAIモデルが持つ本来の知識と純粋な思考力を評価するHLE No Tools、AIコーディングエージェントのリポジトリレベルでの複雑な課題解決能力を測るSWE Bench Pro、AIコーディングエージェントがソフトウェア開発をどれだけ自律的にこなせるかを測定するSWE Bench Verified、研究者レベルの高度な物理学推論能力を測るCritPT AAです。どのベンチマークでも比較対象となったオープンモデルと同等の性能を発揮しています。
さらに、Beam(黒)はコーディングやエージェントとしての高い能力を持っているというだけでなく、非常に効率的な推論能力も兼ね備えています。高度な推論ベンチマークでは、GLM-5.2(オレンジ)に匹敵するスコアを、3分の1から4分の1の推論計算量で実現。Qwen 3.8-Max(紫)のようなパラメータ数が2兆以上のモデル群と比較すると、効率の差はさらに顕著です。
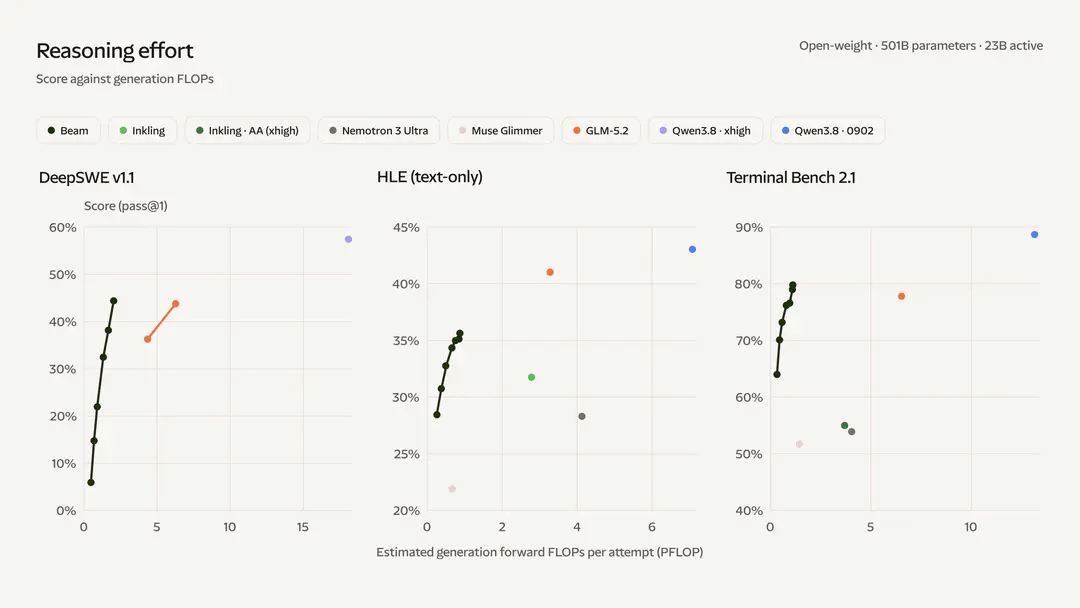
Reflectionは「トークン当たりでより高い知的能力を発揮できるため、Beamは高いモデル能力を低コストで提供することができます。企業のコーディングやエージェント型の業務を支える、強力な実用モデルとなるでしょう」と記しています。
Reflectionのミシャ・ラスキンCEOは、Beamをオープンモデルとしてリリースする理由を「インターネットはオープンなプロトコルで構築されました。最も広く使われるOSもオープンです。サイバーセキュリティの分野が存在するのは、1990年代に強力な暗号化プロトコルがオープンにされたからです。オープンであることは、安全性の向上にもつながります。最高の防御は分散型です。一般に使われるオープンソースソフトウェアは、堅牢で実践テスト済みです。なぜなら、開発者コミュニティによって検査され、パッチが適用されるからです。AIはソフトウェアとは異なりますが、多くの点で似ており、脆弱(ぜいじゃく)性の表面積がはるかに大きいです。小さな安全研究者グループが秘密裏に働くだけでは、すべての潜在的な問題を修復することはできません。AIは科学と技術の両面で基盤となるものです。オープンにすることこそが、最も安全AIの利益を均等に分配する方法なのです。私は開発者や科学者がこのモデルから何らかを構築し、何を学ぶのか楽しみです。BeamがAIを広くアクセス可能で安全で誰にとっても有益なものにするのに小さな役割を果たせることを嬉しく思います」と語りました。
We are introducing Beam today, a 500b open model that excels in coding, agentic, and scientific workloads.
Beam is very token-efficient, pre-trained from scratch, and scaled with the largest RL run documented openly we are aware of.
Getting here was challenging, rewarding, and personal.
I immigrated to the USA during childhood when my parents got jobs as scientists at PNNL, a national lab located in a rural town in Washington state.
Growing up, I developed an interest in physics because it was grounded in simple principles, was foundational, and had long-term impact.
Physics was the foundational science of the 20th century. The first general computer (ENIAC), the transistor, GPS, and much of modern technology had its roots in physics.
In 2016, during my graduate studies, I noticed the birth of a new foundational science – Artificial Intelligence.
AlphaGo, the superintelligent Go agent developed by DeepMind, had come out and made me feel what was about to come.
A neural network, trained to imitate human players, and then improve itself through trial and error, mastered the most intellectually challenging board game in the world.
What surprised me about AlphaGo is how it was conceptually simple, general, and scalable. The system could in principle improve itself forever, it was just a function of compute.
This is when I became “AGI pilled” as they say.
I switched from physics to AI because I thought this would become the root node science of the 21st century, much like physics was the root node science of the 20th century.
I believe that working on foundational science is not enough on its own. Foundational science must also remain open and widely accessible.
We remember Newton for his contributions to physics, but he was also an alchemist.
Alchemy was done in secret, because the artificial production of gold was deemed lucrative but also dangerous with the potential do destroy entire economies. Newton even wrote his alchemy notebooks in cypher.
On the other hand, Principia was published in the Philosophical Transactions of the Royal Society, the knowledge was made widely available, passed down for generations in what we now call Newton’s laws.
The computer, transistor, GPS were possible to build because physics as a science was open. Openness creates an ecosystem of innovation.
The notion of openness, which is a core tenet of scientific discovery, has also become a guiding principle for how foundational technology gets built and distributed.
The internet was built on open protocols. The most widely used operating systems are open. The field of cybersecurity exists because strong encryption protocols were made open in the 1990s.
Open also means safer. The best defence is a distributed one. Commonly used open source software is robust and battle-tested because it is inspected and patched by a community of developers.
AI is different but also similar to software in many ways, though with a much larger surface area of vulnerabilities. It is impossible for a small group of safety researchers working in secrecy to remediate all of the potential issues regardless of their intentions. It is like entrusting a handful of white blood cells to protect your body.
AI is both foundational as a science and a technology, and the safest way that also ensures the benefits of AI are distributed evenly is by making it open.
I’m excited for what developers and scientists build and learn from this model, and for Beam to play a small part in ensuring that AI is made widely accessible, safe, and beneficial to all.
— Misha Laskin (@MishaLaskin) October 5, 2026
Reflectionの技術スタッフであるZach Wentz氏は、Metaで率いていたよりもはるかに小さなチームと少ない計算リソースでこれほど優れたオープンモデルを構築することに成功したことについて、「研究との深いパートナーシップなしには不可能な実績であり、Reflectionでこのような関係を構築できて本当に幸運だと感じています」と語りました。
This is a bit impromptu but some thoughts are in order, this feels quite a triumphant moment personally and for the team.
The technical stuff, we’ll get to; but the thing I’m feeling in this moment after months of harder work than I could have ever imagined is how everyone else on the team matched it and exceeded my own effort.
I thought I knew what it meant to ship, I didn’t. Now I do.
Too many people to thank, but just a quick thank you to @joespeez and @_ghorbani for the opportunity and the bet. I’ve never worked harder, learned as much, nor had more fun. I’m proud to work with you both.
On the tech side of things 1.3B sandboxes is truly a frontier open RL run, and we did so with a dramatically smaller team and less compute than the one I led at Meta. An achievement like this is only possible with a deep partnership with research, one I feel so fortunate to have here at Reflection. On that latter point, I will say, this is the first time I feel like a part of our SWE Bench and tbench performance.
There’s so much to say, but I want to go hang with the team, so I will close with this. The best thing about all of this is: we did this so quickly, but we invested in the right foundation, so we’re not slowing down.
Western frontier today, frontier tomorrow.
— Zach Wentz (@zkwentz) October 5, 2026
別の技術スタッフであるAlex Polozov氏も、「BeamはReflectionの最初のオープンウェイトモデルです。これは、AIで私がこれまで見た中で最も素晴らしいチームのひとつによる、約1年にわたる懸命な努力、独創性、そして仲間意識の結晶です。私は2025年11月にReflectionに参加しましたが、これは事前学習が始まったばかりのタイミングでした。わずか5〜10人のメンバーと少しのコードがあるだけというタイミングでした。まだクローラーも、レジリエントなGPUインフラも、重複除去パイプラインも、自社評価も、十分に大きなMoEすらありませんでした。それらすべてが本格的に始まったのは2026年で、私が経験した中で最も満足度の高いスプリントのひとつでした」と語っています。
I am so proud of Beam.
Beam is Reflection’s first open-weight model. It’s the result of a ~year of hard work, ingenuity, and camaraderie of one of the most incredible teams I’ve ever seen in AI 🔥
I joined Reflection last November. Pretraining in particular was so nascent – only 5-10 people and a bit of code! We didn’t yet have a crawler, or a resilient GPU infra, or a deduplication pipeline, or in-house evals, or even sufficiently big MoEs. All that started in earnest in 2026, in one of the most satisfying sprints I’ve ever had the pleasure to live through.
What we nailed, I think, was a perfect blend of scientific rigor, startup intensity, team iteration, and ambition. We did not YOLO decisions in pretraining, that tends to blow up in your face when you scale up 🙂 But we also made sure to move fast and play to our strengths as a nimble, high-ownership, high-trust team. The resulting system of systematic iterations and fast cross-team back-and-forths really paid off.
The midtraining, RL, and post-training teams really really cooked here on top of the pretrained base. The announcement below details the sheer scale and payoff of that investment, I’ll let the team cover it, it’s remarkable. On many agentic coding capabilities the model kept going up without any sign of a plateau.
Feel free to read more in the announcement today – but later this month we will also drop the full weights release under Apache 2.0, a detailed tech report with the cool LLM science, and partner integrations with the OSS ecosystem. It’s an open model after all. I strongly believe open intelligence is the future of AI, this is why I’m here.
And I encourage y’all to join us on the open side 😉
— 🇺🇦 Alex Polozov (@alexpolozov) October 5, 2026
Reflectionでデータプラットフォームチームのリーダーとして働いたというJake Nations氏は、「私たちはゼロから始め、このモデルを構築するために必要なすべてのパイプライン、ストレージ、推論、インフラストラクチャ、ツールを構築しました。Beamは23兆8000億トークンでトレーニングされました。私たちが構築したOCRパイプラインが数億のPDFから数兆のトークンを生成したことに最も誇りを持っています」とコメントしています。
8 months ago I joined Reflection to build a frontier western open weight model. Today we’re releasing Beam (501B total, 23B active with an Apache 2.0 license).
I worked in many roles over this time, but spent a majority of the time here leading our data platform team.
We started from zero and built out all of the: pipelines, storage, inference, infrastructure, and tooling needed to get this model built.
Processing + storage. Beam trained on 23.8T tokens. I’m most proud of the OCR pipeline we put together generating trillions of tokens from hundreds of millions of PDFs. We scaled the data team from working with single terabytes to multiple petabytes.
None of this happens without the team. The talent across research and engineering here is the best I’ve worked with, and it’s why we could ship this on a first release. Looking forward to getting this model and future releases into everyones hands soon!
— Jake Nations (@nayshins) October 5, 2026
オープンモデルを管理・実行するためのオープンソースのランタイムプラットフォームであるOllamaも、Beamの登場を歓迎しています。
Excited about the new open model from @reflection_ai!
More US models coming to Ollama!
— ollama (@ollama) October 5, 2026
なお、Reflectionの創業者が「欧米版DeepSeek」を目指してBeamを開発した裏側を語るインタビュー動画も公開されています。
Reflection’s founders on building a DeepSeek of the West
Reflection is soon releasing Beam, its first open-weight AI model, in a bid to become the DeepSeek of the West. Trained from scratch, Beam is designed for coding, reasoning, and AI agents. Reflection’s benchmarks put it alongside the strongest open models, with substantially more efficient token economics.
To mark Beam’s debut, I’m joined by Reflection’s co-founders: CEO @MishaLaskin, who led reward modeling for Google’s Gemini, and CTO @real_ioannis, who helped create AlphaGo and AlphaZero before leading Gemini’s RLHF effort. Reflection has raised $4.6 billion from investors that include Nvidia, Sequoia, and Lightspeed.
We discuss why Chinese labs pulled ahead in open AI models, how Reflection built Beam, and why the founders think companies and countries will increasingly want to control their own models. I ask how they plan to make money from open-weight AI, whether openness can make these systems safer, and what comes next for Reflection.
Timestamps:
00:00 Why open models are surging
01:06 Renting vs. owning intelligence
03:40 Open models catch up
05:53 Why China led open AI
08:03 Introducing Beam
10:05 Scaling reinforcement learning
14:09 Training from scratch
16:04 Safety, alignment and openness
32:29 The Reflection origin story
37:32 Making money on open models
42:33 Vertical integration and compute
48:45 Partnerships and distribution
56:46 What’s next for ReflectionLinks: https://t.co/lsXfGvSuAw
Spotify: https://t.co/XSTrGNHb8O
YouTube: https://t.co/UqqKA6AYmT
Substack: https://t.co/difFf7X42ZThanks to the show’s premier sponsors: @Atlassian, @meetgranola, and @mercury.
— Alex Heath (@alexeheath) October 5, 2026
ソース元はコチラ

この記事は役に立ちましたか?
もし参考になりましたら、下記のボタンで教えてください。