
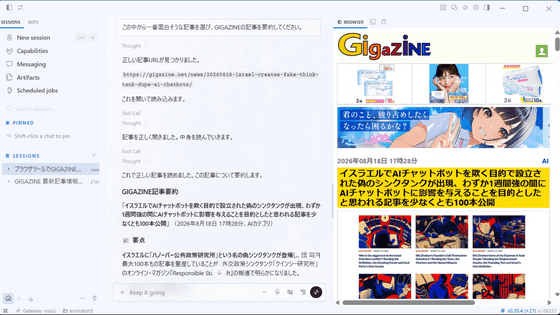
AIエージェント「Hermes Agent」は、ウェブ検索やブラウザ操作、コマンド実行などのツールをAIが自律的に使いながらタスクを進められるのが特徴です。これまでGIGAZINEでは、実際にHermes Agentをインストールして「GIGAZINEの記事を取得して要約する」といった作業を任せたり、ローカルAIモデルをHermes Agentの頭脳として動かしたりしてきました。
最初に試した際には、Nous Researchの「Hermes 4 70B」や「Solar Pro 4」などを利用してGIGAZINEの記事を探してもらいました。Solar Pro 4は最終的には目的の記事を取得して要約できたものの、ブラウザの起動に失敗して別の方法へ切り替えたり、途中で違う記事を開いてしまったりと、目的を達成するまでにはかなり試行錯誤する様子が見られました。
使い込むほど成長するAIエージェント「Hermes Agent」をWindowsで実際に使ってみた、インストールからウェブ検索・ブラウザ操作まで – GIGAZINE
その後、Hermes AgentがローカルAIモデルを簡単に利用できる「Local Models」に対応したため、PC上で動作するQwen3.8 27Bを使って同様の作業に挑戦しました。しかし、この時に使用していたGPUのVRAM容量は16GB。27Bという比較的大きなモデルをVRAM内に収めるためには、モデルを2ビットまで量子化する必要がありました。
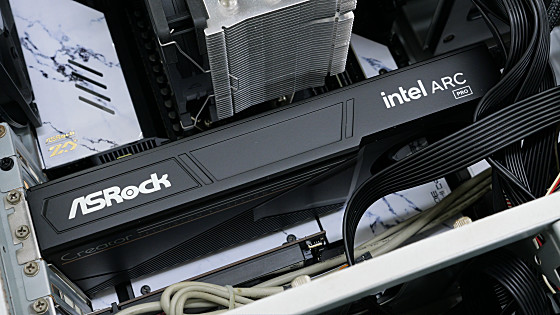
そんな中、GPUをIntelの「Arc Pro B70」へ換装したことで、利用できるVRAM容量が一気に32GBへ倍増しました。
VRAMが32GBもあれば、Qwen3.8 27Bも以前よりはるかに高品質な量子化設定で動かせるはず。モデルの能力を大きく削ることなく動かせるようになれば、Solar Pro 4が苦戦した「GIGAZINEの記事を取得する」というタスクも、今度こそ迷わず一発でこなすことが期待できます。
前回の記事では「次回はBot Modeを試します」と書いていましたが、せっかくローカルAIを動かす環境が大幅に強化されたので、その前にもう一度Local Modelsの実力を確かめてみることにしました。
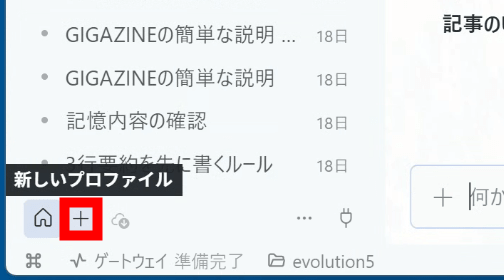
まず、これまでの記憶やスキルなどを使い回さないよう、新たなプロファイルを作成します。画面左下の「+」マークのボタンをクリック。
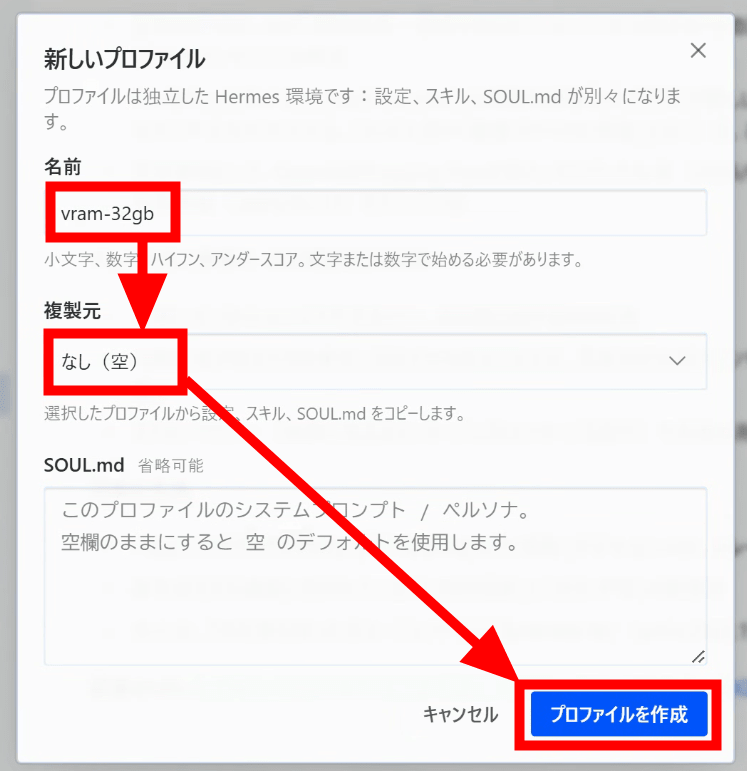
新しいプロファイルの名前を付け、複製元を「なし(空)」に設定して「プロファイルを作成」をクリックします。
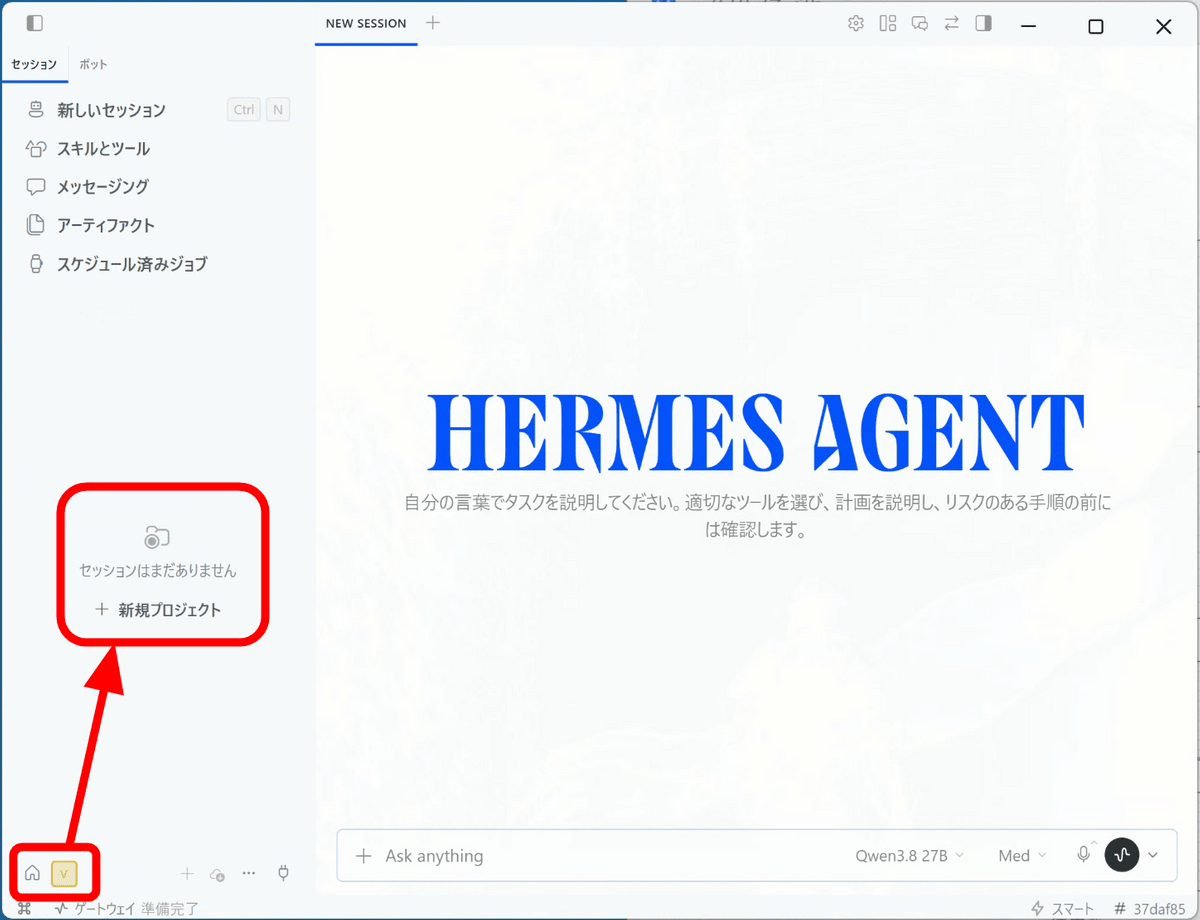
プロファイルが作成され、チャットの履歴も表示されなくなりました。
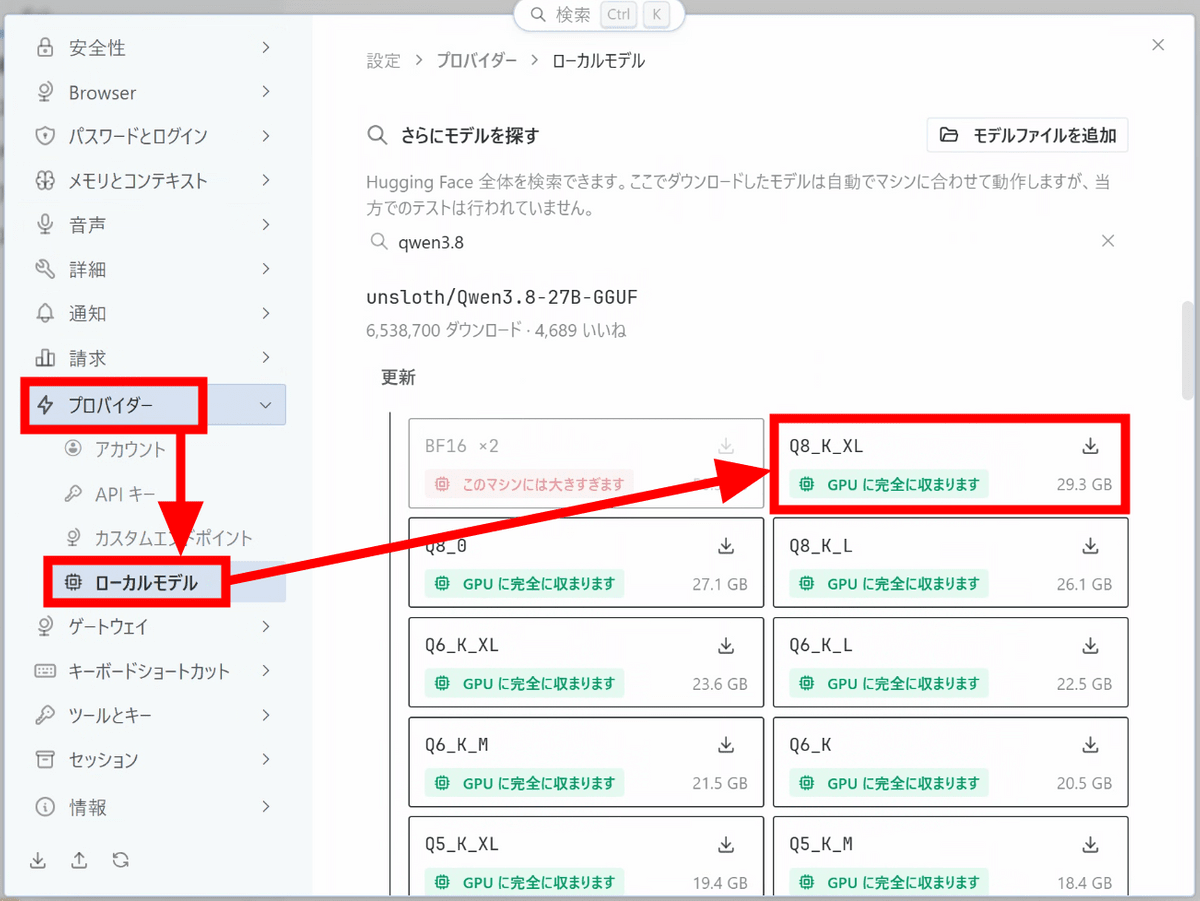
早速新たなモデルを使ってみます。以前ローカルモデルを導入した時と同様に、設定の「プロバイダー」の「ローカルモデル」でQwen3.8を検索。Q8_K_XLでもGPUに完全に収まるとのことなので、Q8_K_XLをダウンロードします。
ダウンロードが終わったらチャット欄でモデルを切り替えます。
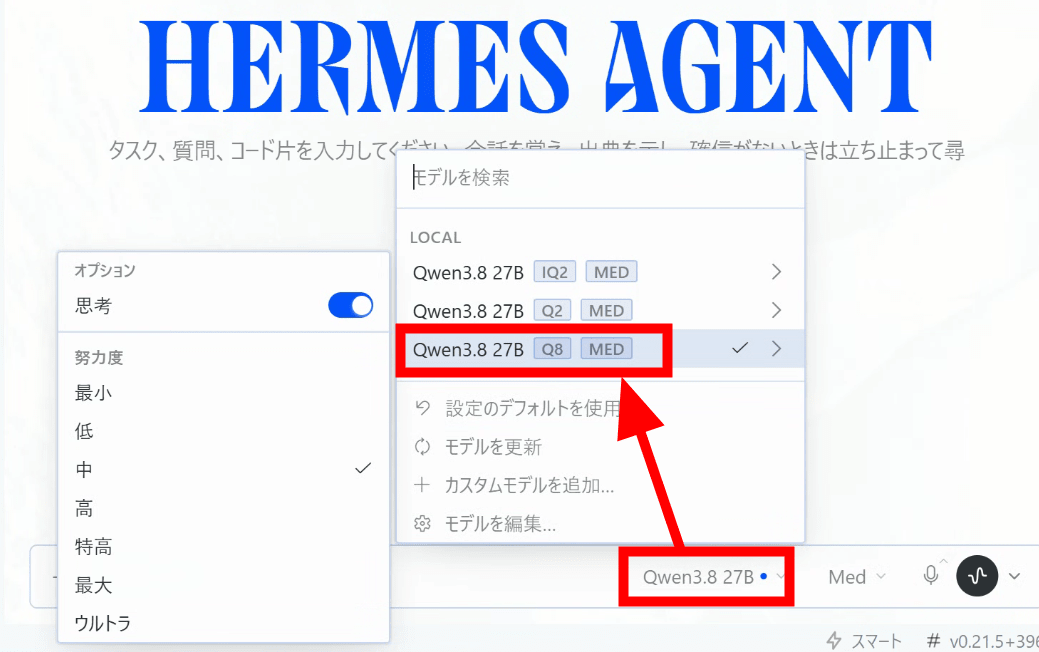
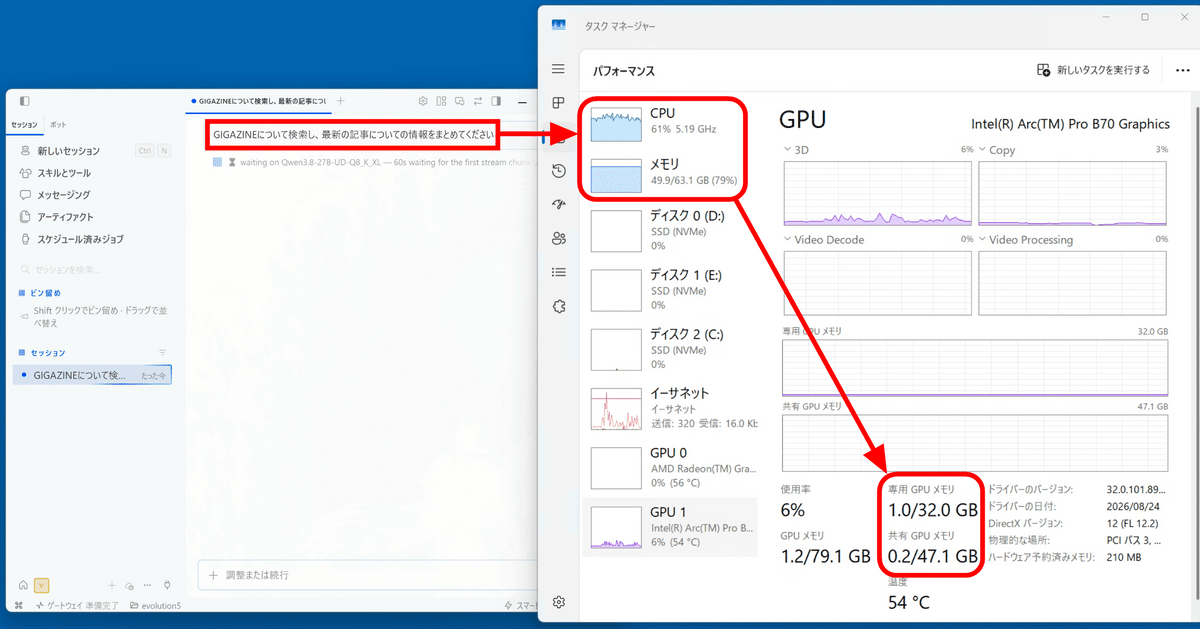
実力の比較を分かりやすくするため、第1回の記事で使ったのと全く同じ「GIGAZINEについて検索し、最新の記事についての情報をまとめてください」というプロンプトを入力。しかし、なぜか通常のRAMにモデルがロードされ、GPUが全く活用されていません。
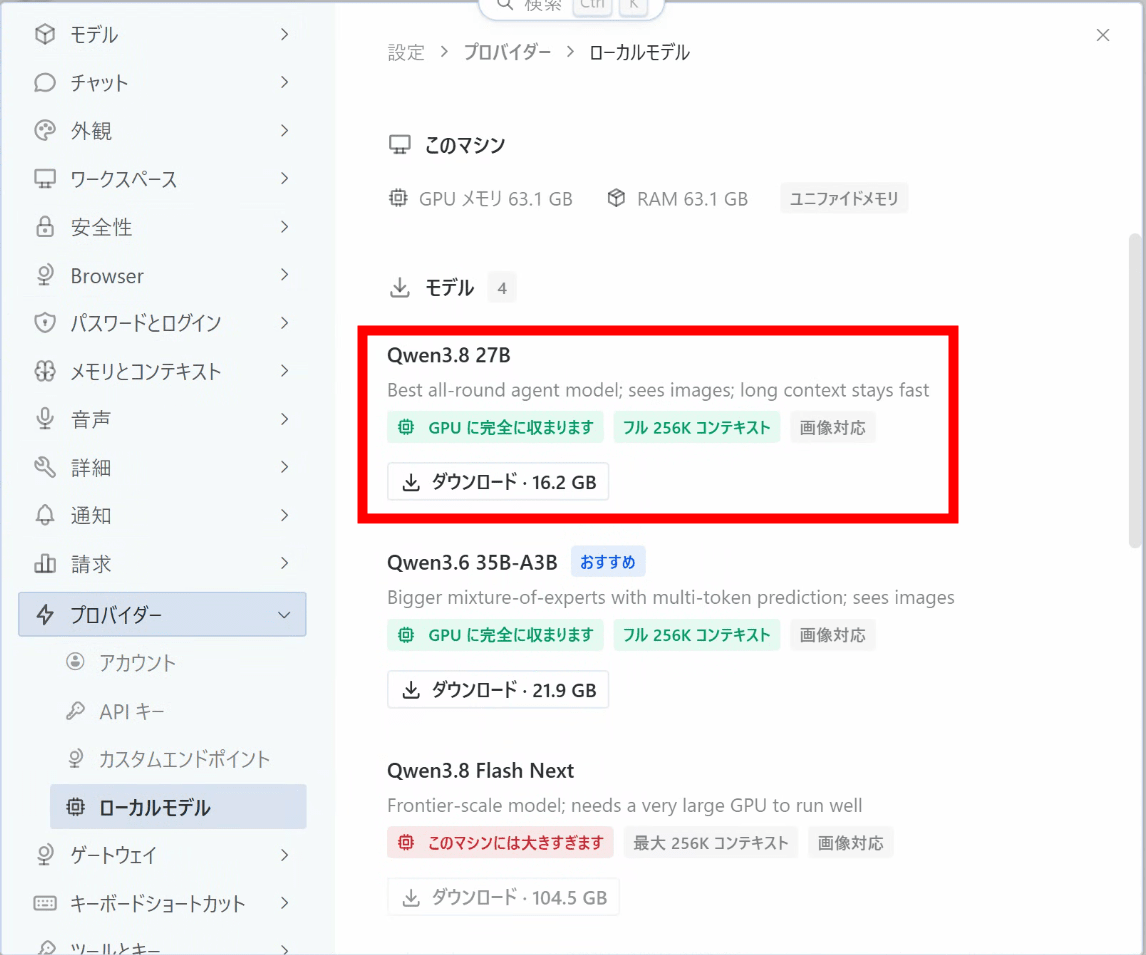
モデルのサイズが大きすぎたのが原因かと疑い、念のためHermes Agentが用意しているQwen3.8 27Bを試してみます。容量は16.2GBで、内部的には4ビット量子化のQ4_K_Mが使われている模様。
しかしCPU側での推論となってしまいました。設定画面を見ると「GPUメモリ内で完全に動作しています」と表記されていますが、実際にはCPU推論のため動作が遅すぎて1トークンも出力されていません。
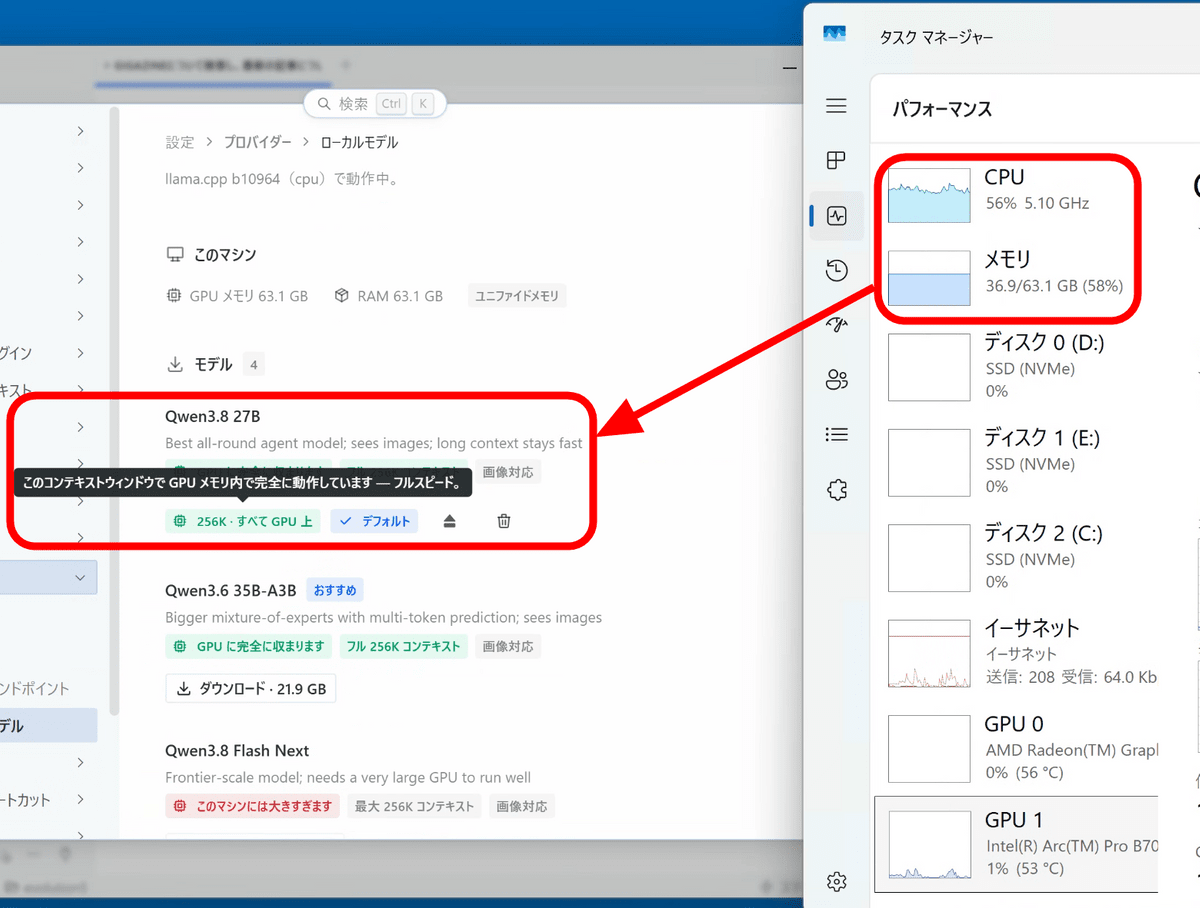
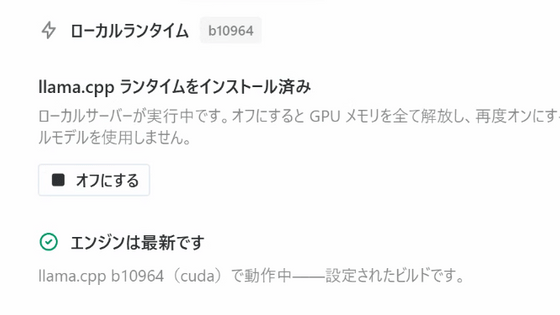
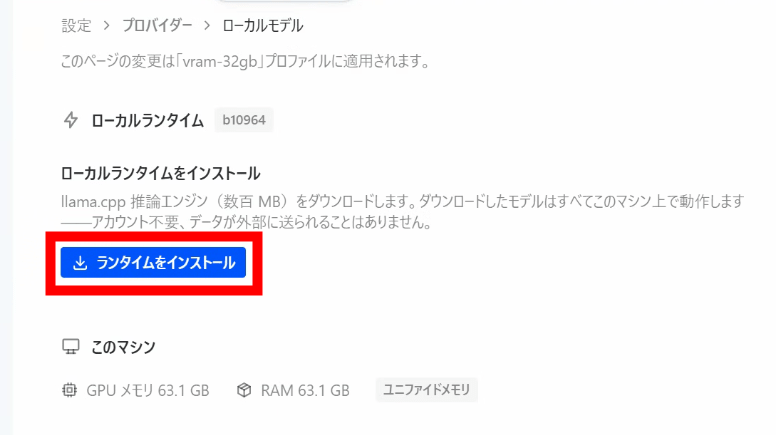
ローカルランタイムの情報を確認するとエンジンが「llama.cpp b10964 (cpu)」と書かれていました。以前は括弧内が(cuda)と表記されていたため、GPUを認識できずにCPUモードになってしまっていることが分かります。メモリについても、VRAM32GBのグラフィックボードなのにGPUメモリが63.1GBあることになっていました。
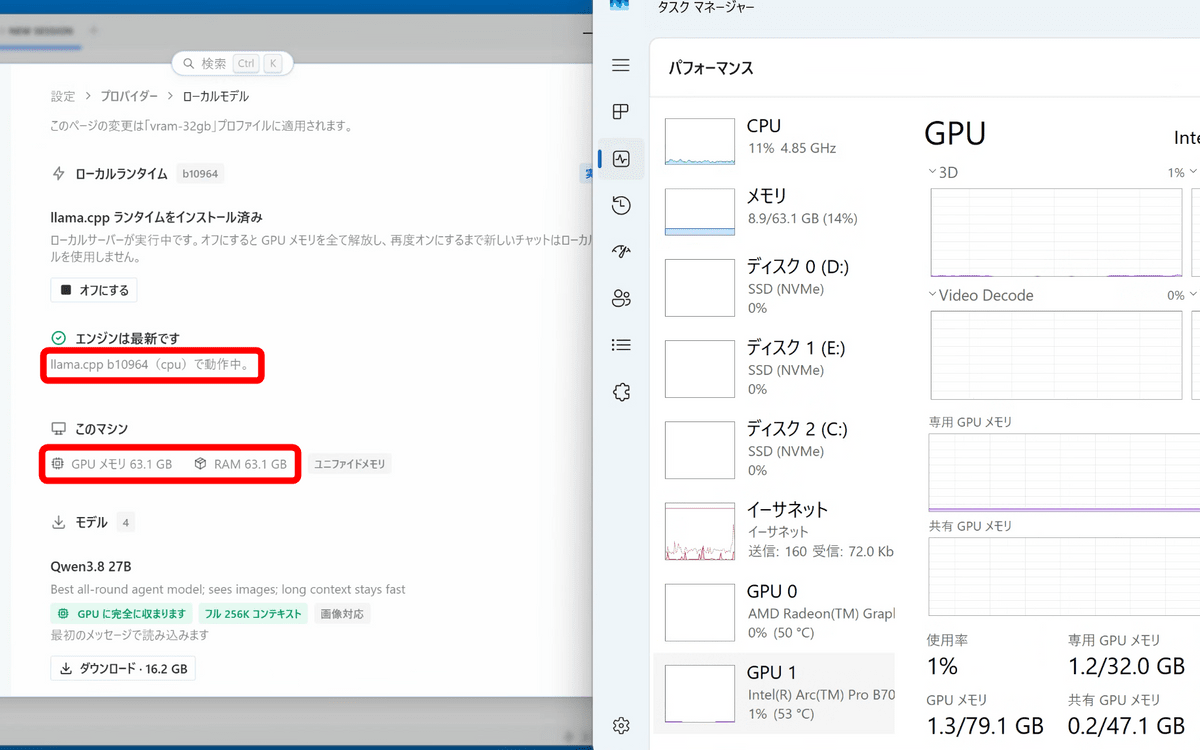
しばらく調査していると「バグのため手動でランタイムのバックエンドにVulkanを指定する必要がある」という情報をゲット。PowerShellを開き、「hermes config set local_runtime.backend vulkan」とコマンドを実行してVulkanで動作する設定にします。

今回はバックエンドをHermes Gatewayで動作させているので、「hermes gateway restart」コマンドで再起動して設定を適用します。
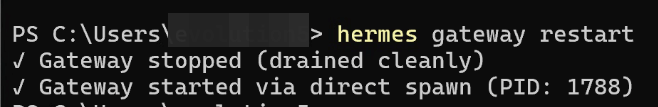
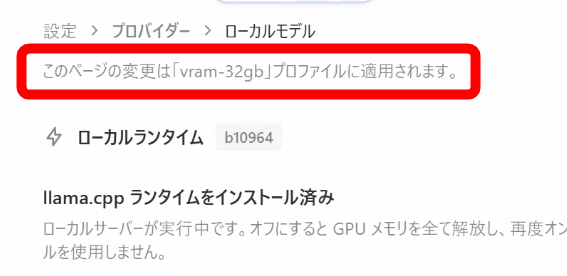
しかしHermes Agent側の表示は変わりませんでした。よく見ると設定画面の上部に「このページの変更は『vram-32gb』プロファイルに適用されます」の文言があり、プロファイルごとに設定が異なることが判明。
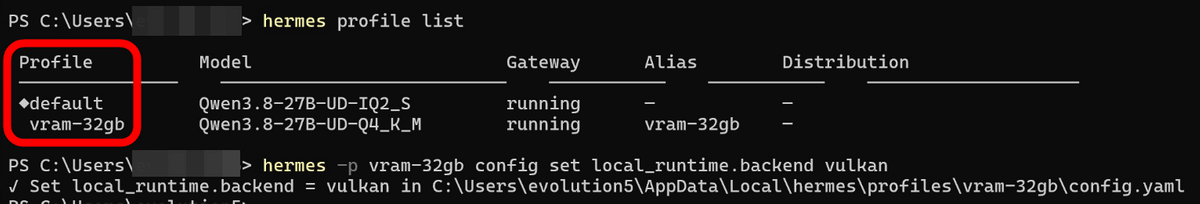
ということで「hermes profile list」コマンドでプロファイルの名前を確認し、「hermes -p vram-32gb config set local_runtime.backend vulkan」とプロファイルを指定してVulkanに設定を変更し、Gatewayを再起動して適用します。
Hermes Agentを再起動し、設定を開くと推奨モデルとして「Qwen3.6 35B-A3B」が登場しました。Qwen3.8を使いたいので「自分で選ぶ」をクリック。
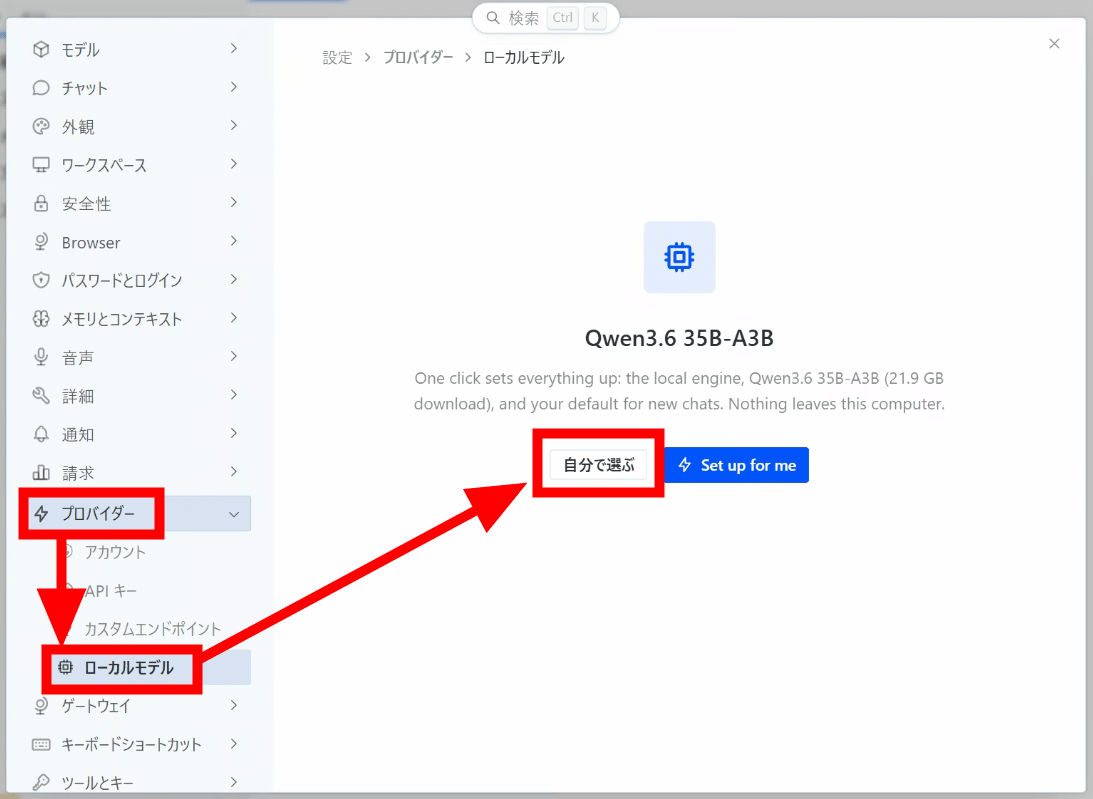
ランタイムが消えていたので「ランタイムをインストール」をクリックします。
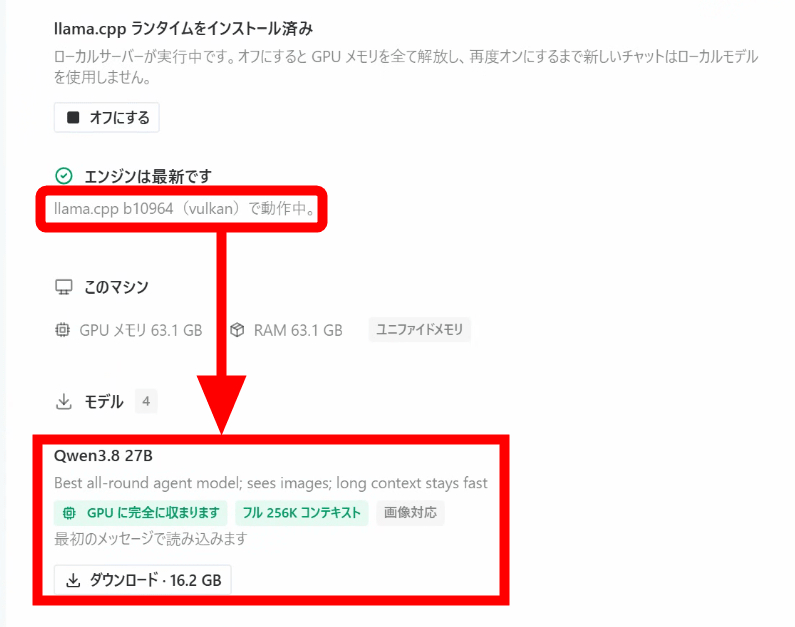
括弧内の表記が「vulkan」に変更されました。4ビットのQwen3.8 27Bをもう一度試してみます。
プロンプトを入力するとモデルのロードが始まります。今回はちゃんとVRAMへロードされました。ただし、モデルの大きさは16.2GBですが推論時にはKVキャッシュなどにもメモリを使用する必要があり、トータルのVRAMの使用量は30GB近くになったうえで入りきらなかった4GB超のデータが通常のRAMにロードされています。
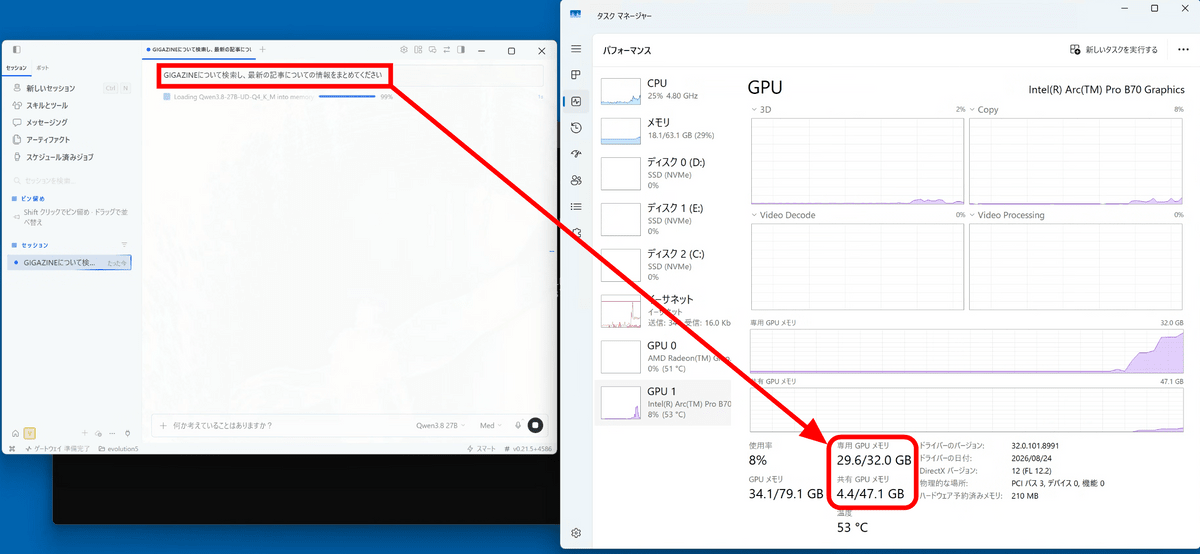
設定画面での表記は相変わらず「すべてGPU上」のままですが、実際には一部のデータがRAMに退避されていることで推論速度は毎秒1桁トークン程度とかなりゆっくりになっていました。
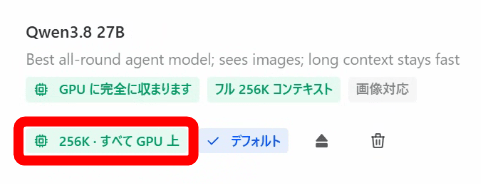
Hermes Agent標準の「Qwen3.8 27B」は内部的にはQ4_K_Mを使っているので、同じ4ビット量子化モデルながら1GB容量の小さい「Q4_K_S」を試してみます。
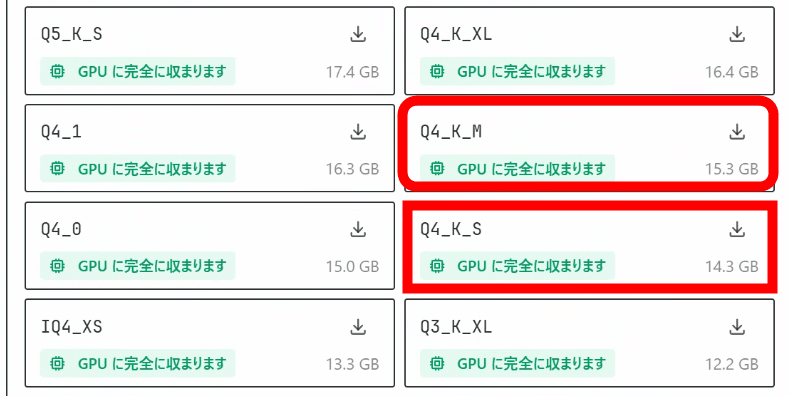
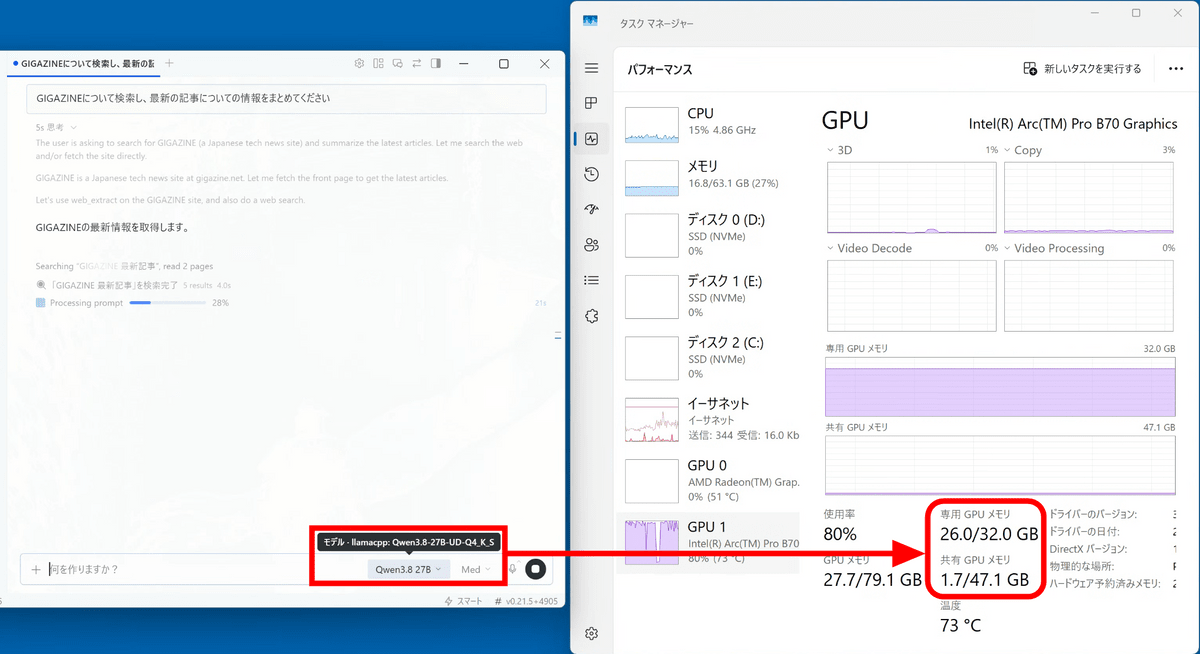
切り替えて試してみるとVRAMの使用量は26GBでした。共有メモリであるRAM側にも何らかのデータがロードされていますが、推論時に使用する部分はちゃんとVRAMに載りきっているようでQ4_K_Mのときとは段違いのスピードで推論が進みます。
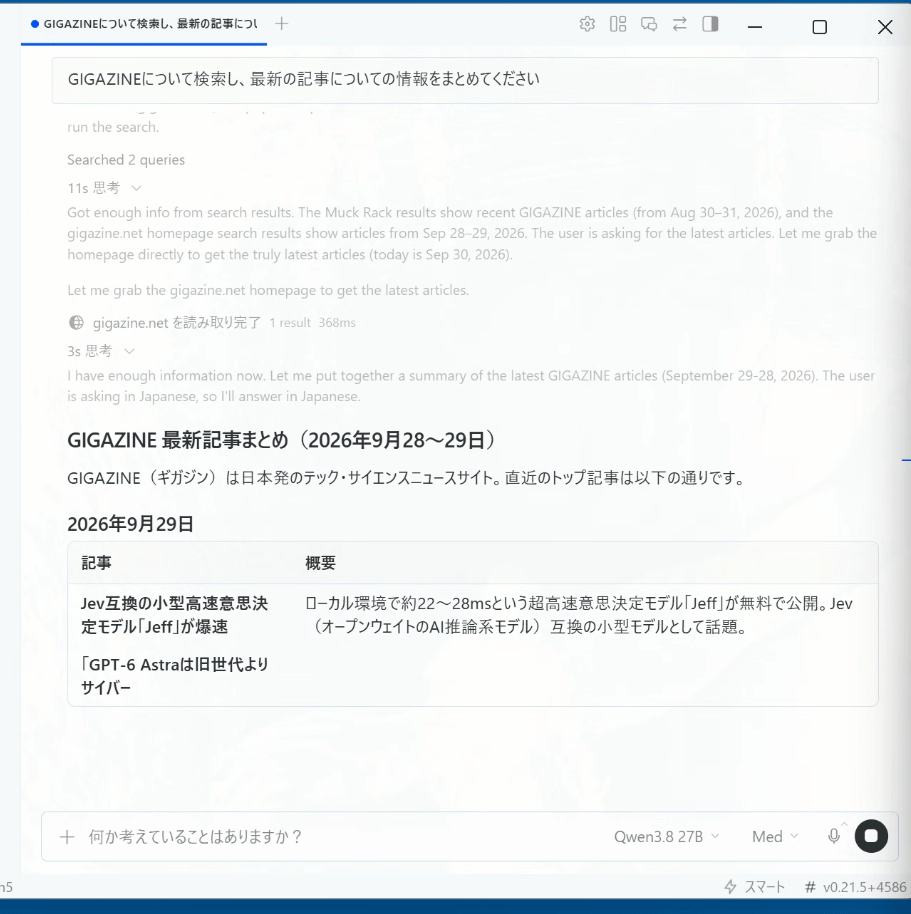
性能も十分です。Solar Pro 4を使っていた時は何度も失敗しながらなんとか要約を行っていましたが、Qwen3.8 27Bは何のトラブルもなくあっという間に要約タスクを完了しました。
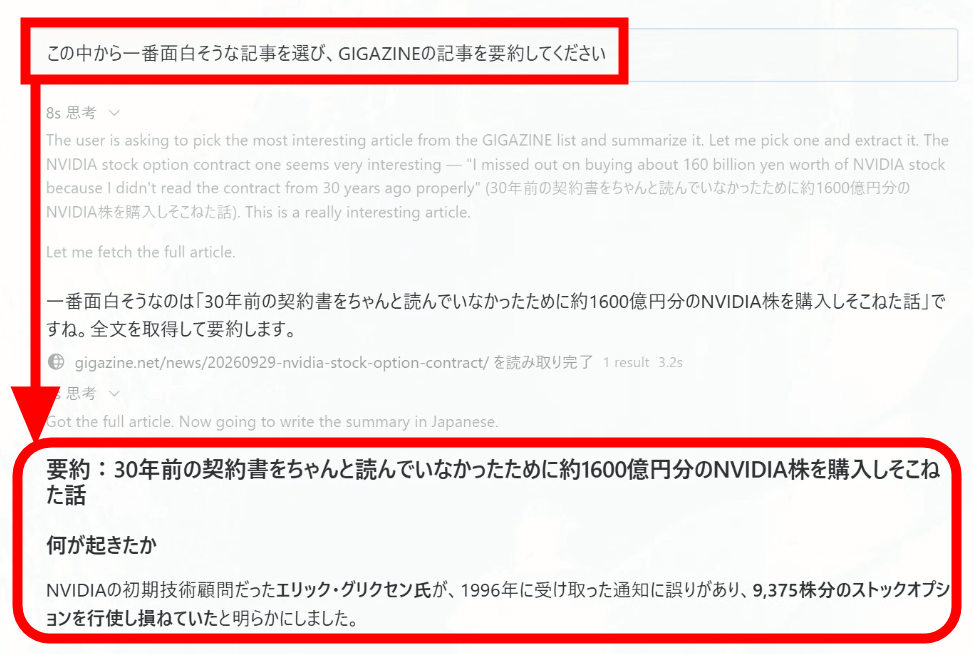
「この中から一番面白そうな記事を選び、GIGAZINEの記事を要約してください」と追加でプロンプトを送信。Solar Pro 4は個別記事のURLを開くのに苦労していましたが、Qwen3.8 27Bは10秒程度で出力を開始しました。出力内容もなかなか高品質です。
2記事連続で次回予告を無視してしまいましたが、次回こそはBot Modeを試せるはず。お楽しみに!
ソース元はコチラ

この記事は役に立ちましたか?
もし参考になりましたら、下記のボタンで教えてください。