
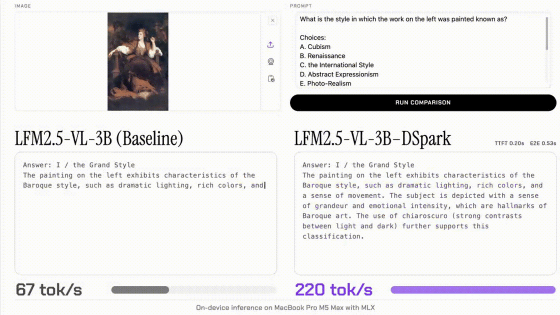
アメリカに拠点を置くAI開発企業のLiquid AIが視覚言語モデル「LFM2.5-VL-3B-DSpark」を2026年9月24日に公開しました。LFM2.5-VL-3B-DSparkは「LFM2.5-VL-3B」に投機的デコード技術「DSpark」を適用したモデルで、性能を維持したまま数倍の高速化を実現しています。
LFM2.5-VL-DSpark: Accelerating vision-language models on edge and beyond | Blog | Liquid AI
https://www.liquid.ai/blog/lfm2-5-vl-dspark
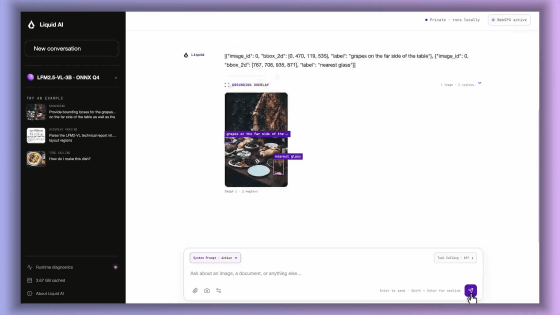
Liquid AIはノートPCやスマートフォンでローカル実行できる小型モデルの開発に取り組む企業です。2026年8月に登場したLFM2.5-VL-3Bはスマートフォンで実行できる小型モデルでありながら「文書のOCR」「UIの認識」といった操作をこなすことができる高性能モデルとして注目されています。
スマホで動く視覚言語モデル「LFM2.5-VL-3B」が登場、日本語対応でUI認識やOCRに活用できる – GIGAZINE
新たに、LFM2.5-VL-3Bに投機的デコード技術のDSparkを適用したLFM2.5-VL-3B-DSparkが公開されました。投機的デコードは「メインのAIモデルとは別に小型かつ高速なドラフトモデルを用意し、ドラフトモデルでメインモデルの出力トークンを先に予測しておく」という仕組みの高速化技術で、メインモデルの出力品質を完全に維持したまま高速化することができます。
VLMではテキストだけでなく画像も扱う必要がありますが、ドラフトモデルには「メインモデルで多次元配列に変換したデータ」のみが渡されるため入力データの種類は関係ないとのこと。このため、Liquid AIはLLM向けに開発していたドラフトモデルのアルゴリズムをそのままLFM2.5-VL-3B-DSparkの開発に適用できたそうです。
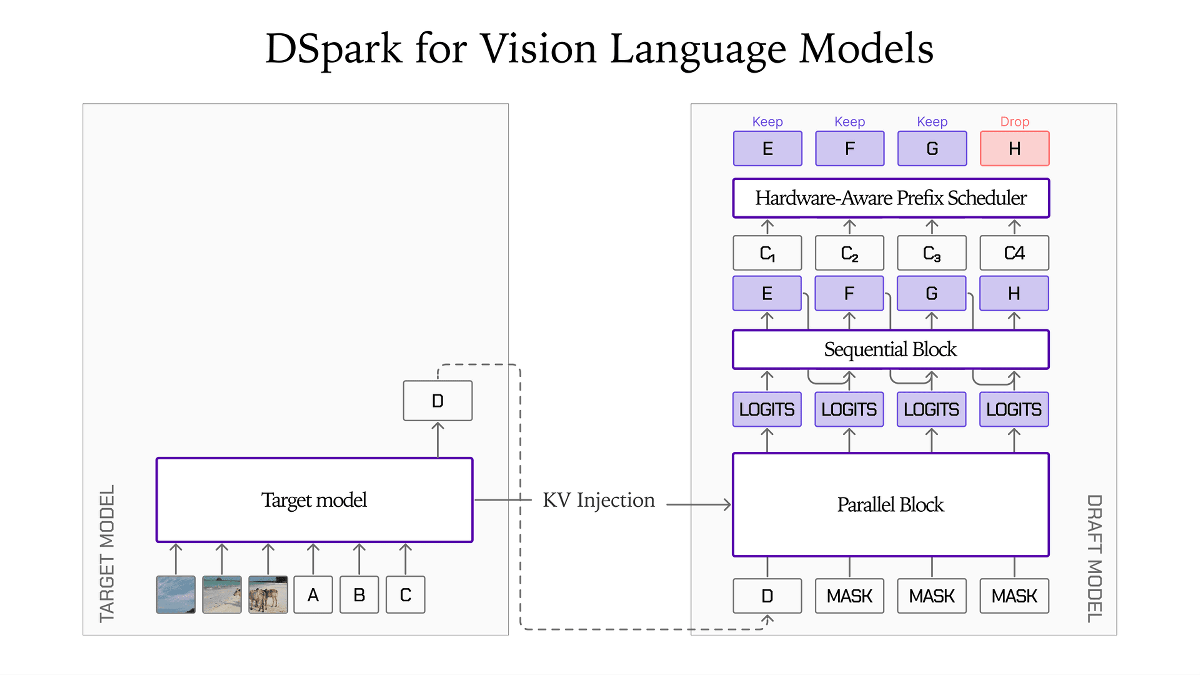
LFM2.5-VL-3B-DSparkのドラフトモデルのパラメーター数は2億8000万で、LFM2.5-VL-3Bと比べて総パラメーター数が8.9%増加し、使用するメモリ容量も増加。使用メモリの増加と引き換えに大幅な高速化を達成しています。
LFM2.5-VL-3B(黒色)とLFM2.5-VL-3B-DSpark(青色)の処理速度を比較したグラフが以下。M5 Maxを搭載したMacBook Pro上で両モデルを用いてベンチマークテスト「MMMU-Pro」を実行した場合、LFM2.5-VL-3B-DSparkの方がデコード速度が2.93倍高速で、プリフィルとデコードを合わせた処理全体の速度も2.62倍に高速化しました。
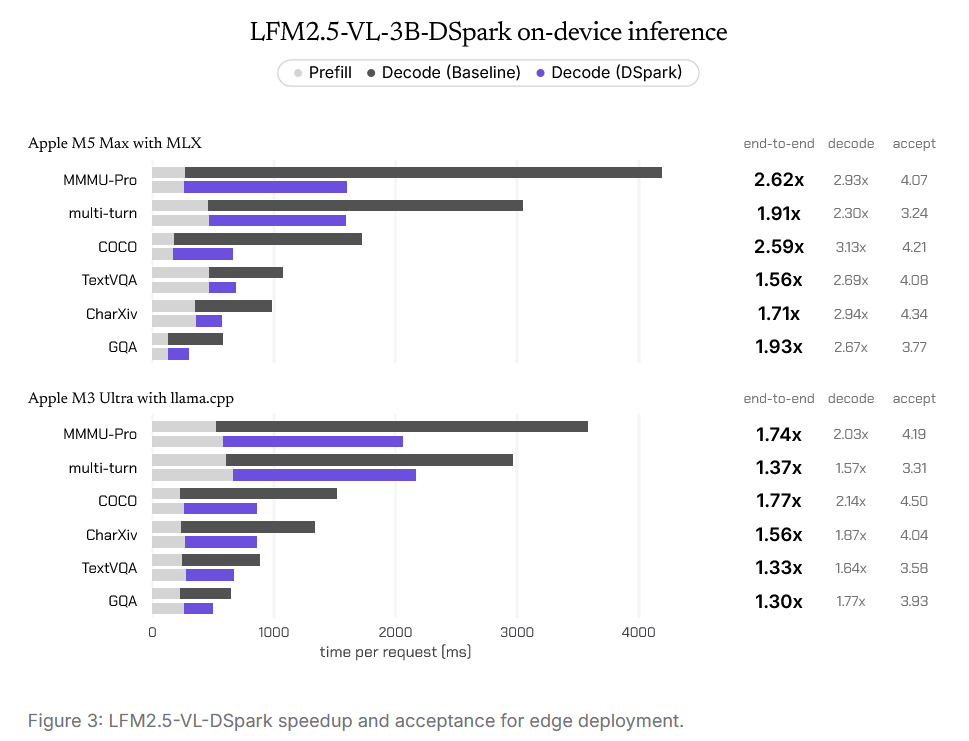
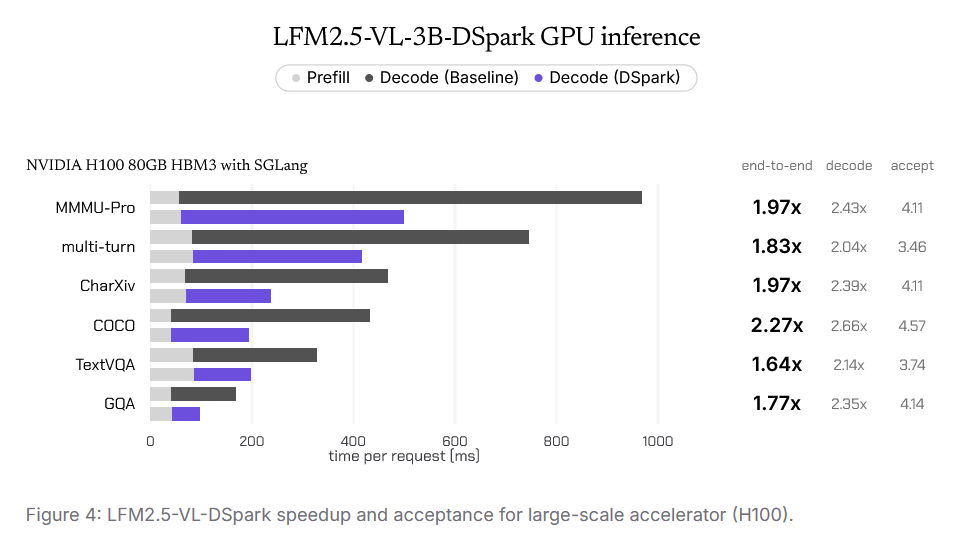
H100でも同様に大幅な高速化を記録。MMMU-Proの場合はデコード速度が2.43倍、全体の処理速度が1.97倍に向上しています。
LFM2.5-VL-3B-DSparkはオープンモデルとして公開されており、以下のリンク先からダウンロードできます。すでに「llama.cpp」「MLX-VLM」「SGLang」で推論が可能となっています。
LiquidAI/LFM2.5-VL-3B-DSpark · Hugging Face
https://huggingface.co/LiquidAI/LFM2.5-VL-3B-DSpark
ソース元はコチラ

この記事は役に立ちましたか?
もし参考になりましたら、下記のボタンで教えてください。