
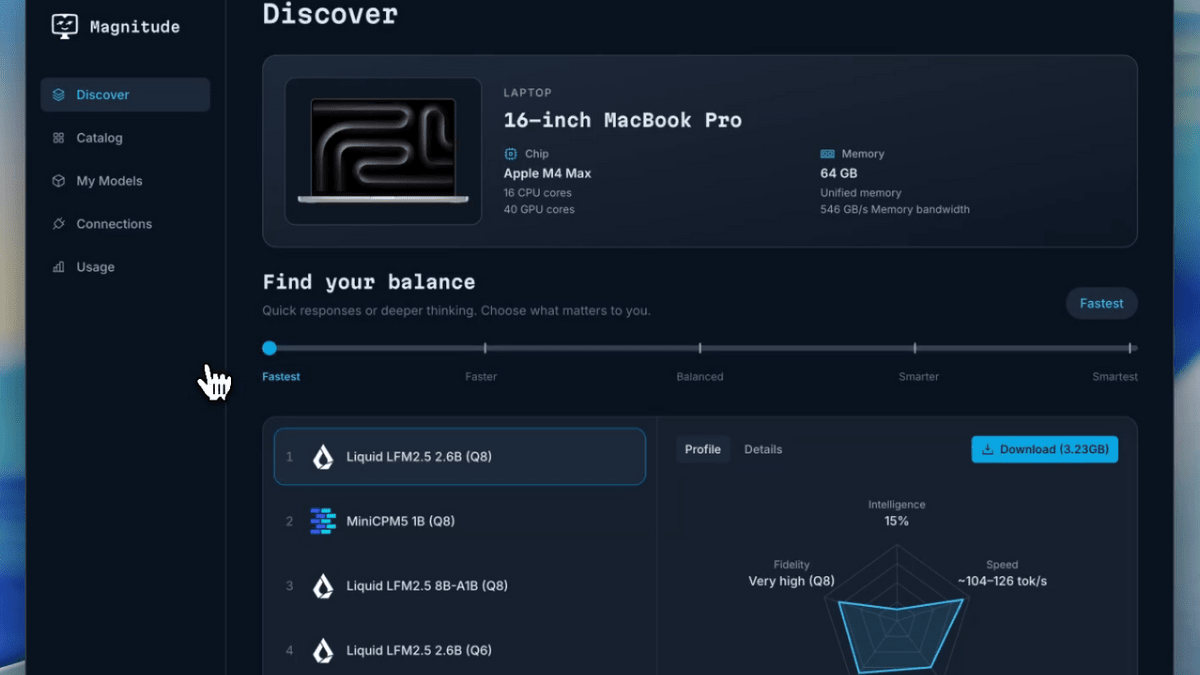
AIエージェントでオープンモデルをローカル実行する際に、使用中のハードウェアに合わせて処理を自動調整するオープンソースの推論エンジン「Magnitude」が公開されています。Magnitudeはモデルを実行するための処理を端末上でコンパイルして調整する仕組みを備えており、特定の条件では「llama.cpp」と比べて最大約2倍の速度を記録しています。AppleシリコンやNVIDIA・AMD製GPUに加えてCPUのみのPCでも動作し、Pi、OpenCode、Hermes、CodexなどのAIエージェント用ツールと簡単に接続できます。
GitHub – magnitudedev/magnitude
https://github.com/magnitudedev/magnitude
Launch HN: Magnitude (YC S25) – Self-optimizing inference engine for agents | Hacker News
https://news.ycombinator.com/item?id=49911995
大規模言語モデルを自分のPCで動かす方法として、オープンソースの推論エンジン「llama.cpp」が広く利用されています。llama.cppは2023年3月に登場し、CPUのみのPCやAppleシリコン搭載Macでも大規模言語モデルを動かせるため、ローカルAI実行の定番ツールの1つとなりました。2025年5月にはマルチモーダル入力にも対応しています。
ローカルで各種AIモデルを実行できる無料ソフト「llama.cpp」がマルチモーダル入力をサポートし画像の説明などが可能に – GIGAZINE
一方でAIエージェントを動作させる場合、ファイルの読み書きやコマンド実行などを繰り返すため会話が長くなりやすいほか、複数のエージェントを同時に動かすこともあります。Magnitude開発チームは、データセンター向けの推論エンジンは大量のリクエストをまとめて処理する用途が重視され、llama.cppなどは幅広いハードウェアへの対応が重視されているため、ローカルPC上でAIエージェントを長時間動かす用途には別の最適化が必要だと考えたとのこと。
Magnitudeは「実際にモデルを動かすPC上で自動調整する」という方法を採用。AIモデルの計算を担当する小さな処理単位である「カーネル」を実行する端末に合わせてコンパイルし、パラメーターも端末上で調整します。同じAppleシリコンやNVIDIA製GPUでも製品ごとに性能やメモリ構成は異なるため、幅広いハードウェア向けに用意したカーネルを使う方式と比べ、実際の端末上でカーネルを調整することで処理速度を引き上げることが可能です。
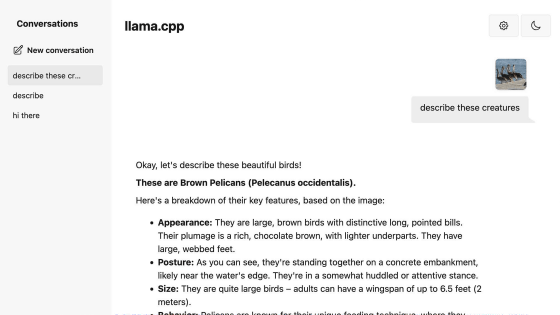
Magnitude開発チームは4bit量子化した「Qwen 3.6 35B A3B」を64Kトークンのコンテキスト長で動かしてllama.cppと比較。M4 Proと48GBメモリを搭載したMacでは、Metal使用時の生成速度はllama.cppが毎秒30トークンであるのに対してMagnitudeは約92%増の毎秒57トークンを記録。プリフィル速度はllama.cppが毎秒466トークンで、Magnitudeは毎秒507トークンと約9%の向上を達成しています。NVIDIA DGX Sparkを使ったCUDA環境でも、生成速度はllama.cppの毎秒49トークンよりも高速な毎秒58トークン(約19%増)、プリフィル速度はllama.cppが毎秒2033トークンであるのに対してMagnitudeは毎秒2507トークン(約23%増)を記録。エージェント1つ当たりのメモリ使用量もMetal環境で約28%、CUDA環境で約27%削減することに成功しました。
AIエージェントを複数動かした際のメモリ消費にも対策が行われており、Magnitudeは最初にモデルの重みを保持するために必要なメモリだけを確保し、エージェントとのセッションが長くなるにつれて必要なメモリ領域を動的に増やす機能を搭載。エージェントが停止すると確保していた領域を解放するため、AIエージェントを動かしながら同じPCで別の作業を続けやすくする仕組みになっています。
また複数のセッションで同じシステムプロンプトや共通部分を繰り返し処理する無駄を抑えるため、Magnitudeは複数のセッションで共通する冒頭部分の計算結果を再利用する「プレフィックスキャッシュ」を共有する仕組みも採用しています。AIエージェントではツールの説明など多くの共通テキストを何度もモデルへ渡すことがあるため、単純な生成速度だけでなく長時間・並列運用時の効率も重視しているというわけ。
導入時にはMagnitudeが搭載ハードウェアを調べ、推奨モデルを提示します。モデルを選択してダウンロードした後は「Connections」からPi、OpenCode、Hermes、OpenClaw、Codex、Claude Code、Oh My Pi、Clineなどへ接続可能。ほかのアプリから利用したい場合はOpenAI互換APIも用意されています。macOS、Windows、Linuxに対応し、Appleシリコン、NVIDIA製GPU、AMD製GPUのほかCPUのみの環境でも利用可能です。
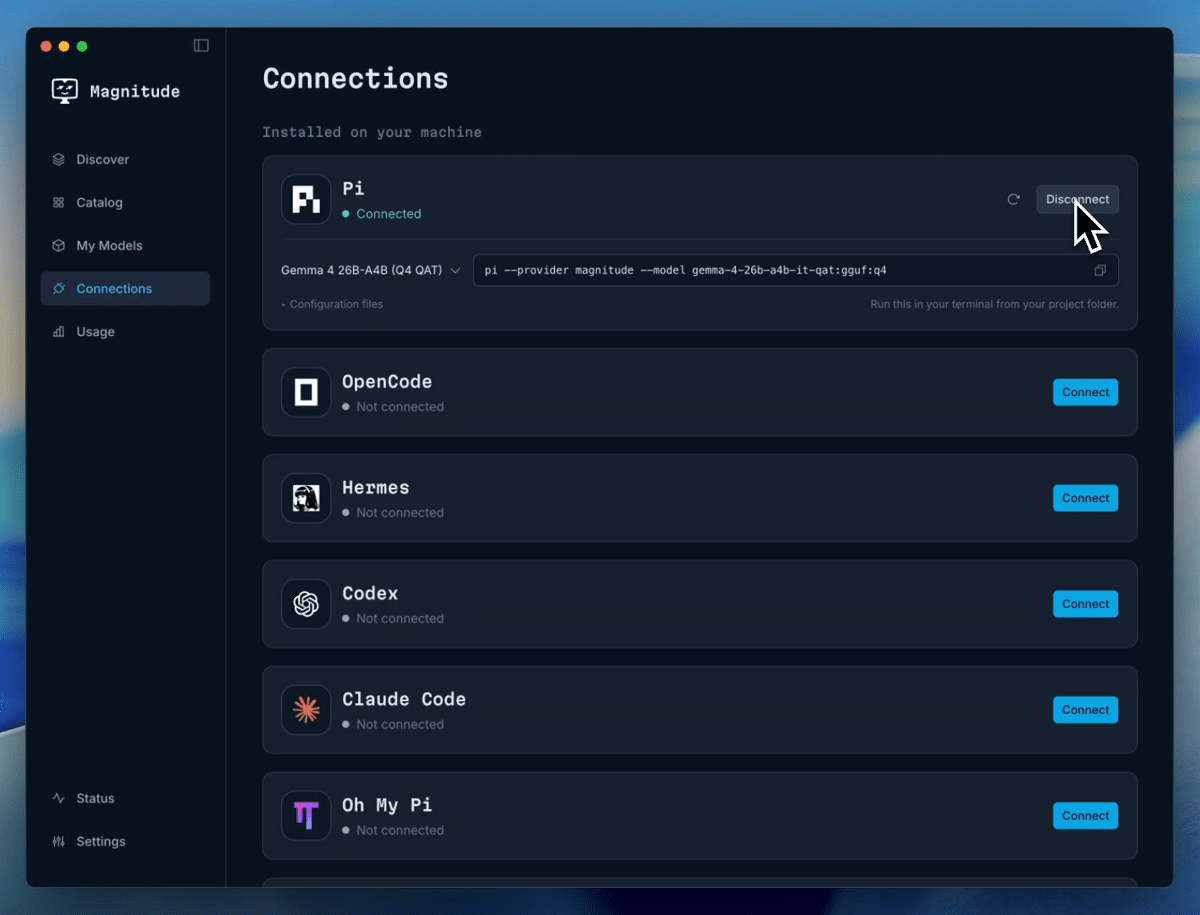
モデルは必要になった際に読み込まれ、しばらく使われなかった場合や空きメモリが少なくなった場合には自動的に解放される仕組み。モデルを一度ダウンロードすればインターネット接続なしでも利用でき、プロンプトやファイルはPC内に保持されるとのこと。Magnitude自体はApache License 2.0で公開されています。
Magnitude開発チームは今後、GPUメモリに収まらない大規模モデルの「エキスパート」と呼ばれる一部のパラメーターをRAMやストレージに置き、必要なタイミングで読み込む「Expert streaming」や、カーネルの構成そのものを自動決定するコンパイラ、CPU・GPU・RAM・ストレージをまとめて活用する複数デバイス向けの最適化を計画しているとのことです。
ソース元はコチラ

この記事は役に立ちましたか?
もし参考になりましたら、下記のボタンで教えてください。